

Estado del mercado 2026–2027: por qué el rigging manual se ha convertido en un lujo
A finales de 2026, la industria redefinió definitivamente el rol del arte técnico. El skinning manual y la construcción de jerarquías de huesos a partir de un "esqueleto" base pasaron a ser servicios premium, disponibles únicamente para los protagonistas de títulos AAA o sistemas mecánicos específicos. Para estudios indie, equipos de outsourcing y desarrolladores móviles, el pipeline clásico ya no existe como práctica masiva. La razón reside en la ruptura radical entre la velocidad de prototipado de los diseñadores de juegos y la capacidad de procesamiento de los departamentos de animación.
Los requisitos modernos de las tiendas sobre la frecuencia de actualizaciones de contenido —especialmente en el segmento de juegos LiveOps en Unity (versiones 6.x) y Unreal Engine 5.5/5.6— exigen lanzar nuevos skins, emociones e interacciones semanalmente. En condiciones de escasez de riggers senior, cuyos salarios siguen creciendo a ritmo acelerado, el trabajo manual sobre cada activo se vuelve económicamente tóxico. Un estudio simplemente no puede permitirse gastar dos o tres días laborales de un especialista de alto nivel en la preparación de un NPC secundario o un objeto de personalización variable.
El motor principal de estos cambios han sido los módulos de IA integrados dentro de los propios motores gráficos. MetaHuman Animator 2.0 dejó de ser una herramienta exclusiva para la fotorrealidad; su núcleo ahora se utiliza masivamente para retargeting transferencial incluso en modelos estilizados gracias a algoritmos mejorados de correspondencia geométrica. En Godot 4.5, el soporte nativo de plugins de redes neuronales permite generar pesos de piel (skin weights) directamente en el editor mediante descripciones textuales de zonas de deformación ("doblado blando del codo", "fijación rígida de la armadura"). Esto redujo la etapa de preparación de la base a unos minutos en lugar de horas de selección de padding y copia espejo.
El modelo económico pasó de pagar por horas de trabajo a pagar por la calidad de la forma final. El pipeline de 2026 funciona así: el artista conceptual entrega un bloqueo en ZBrush o un escaneo High-poly, un modelo ML genera un rig borrador y la animación primaria del movimiento (motion synthesis), mientras que el artista técnico actúa solo como corrector de errores de interpolación de articulaciones. Herramientas como Autodesk Character Generator AI y soluciones open-source basadas en transformers aprendieron a entender la física de los tejidos durante la creación de la estructura ósea, colocando automáticamente cápsulas de colisión donde una persona suele equivocarse con ropa ceñida.
Para el desarrollo móvil, el factor crítico fue la optimización para los chips de la serie Snapdragon Elite 2026 y Apple A19 Bionic. Las redes neuronales de generación de animaciones ahora están entrenadas para considerar las limitaciones en tiempo real: producen curvas de rotación sin llaves innecesarias y sugieren inmediatamente el nivel óptimo de LOD para la malla de influencia. Si antes el rig procedural era visto como un compromiso de calidad por velocidad, hoy renunciar a él significa perder en el ritmo de salida de parches. Los jugadores esperan contenido estacional sincronizado en todas las regiones, y un equipo atado al peso manual de vértices no puede cerrar físicamente los sprints a tiempo.
En el contexto del outsourcing gráfico, esto ha llevado a la estandarización de los datos de entrada. Los clientes dejaron de solicitar archivos .rig completos. En su lugar, se transmite un dataset de poses limpias T-Pose/A-Pose y una descripción del comportamiento a través de Motion Canvas. El ejecutor utiliza instancias cloud con GPU de última generación para calcular las deformaciones, devolviendo al cliente FBX listos con Blend Shapes aplicados para la sincronía facial. La edición manual de vértices quedó relegada a micro-pausas en cinemáticas, mientras que todo el resto del volumen de movimientos se crea algorítmicamente.
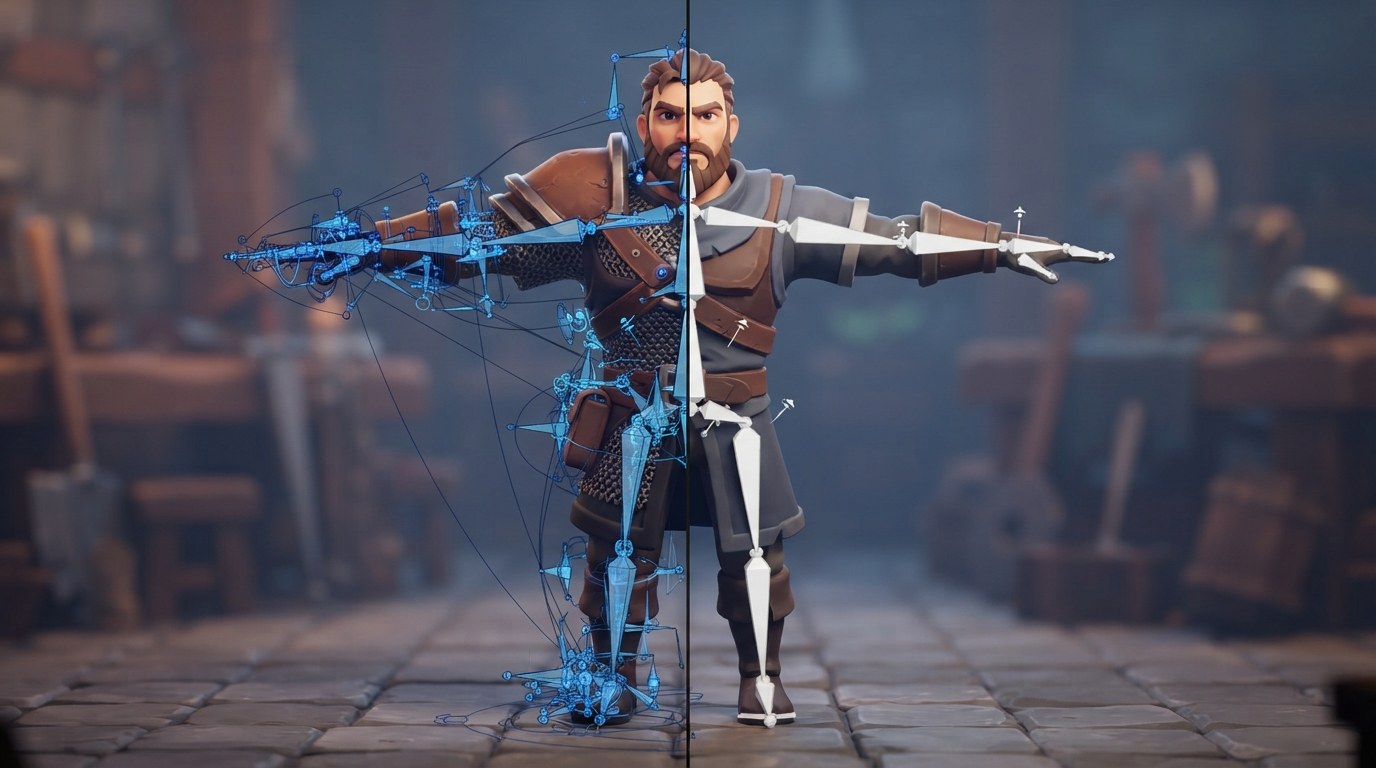
Evolución de las herramientas: qué ha cambiado en Auto-Rig Pro, AccuRig y Mixamo en dos años
Durante 2025–2026, el pipeline de rigging dejó de ser un oficio manual. El principal cambio fue la transición de la "semi-automatización" a redes predictivas que no solo encadenan huesos, sino que predicen la arquitectura funcional del esqueleto para un silueta específica. Si antes las herramientas luchaban contra la simetría y los pesos, ahora discuten sobre las limitaciones cinemáticas y la corrección física incluso antes de exportar el FBX.
Auto-Rig Pro (versión 4.x para Blender) desplazó definitivamente su foco hacia la modularidad mediante la API Graph nativa. La novedad más importante fue el modo Neural Blueprint. En lugar de indicar manualmente los puntos de control de las escápulas o clavículas, solo se establecen marcadores para la pelvis y el cráneo. La red analiza la topología de la malla, reconoce las zonas anatómicas por clusters de UV y construye una jerarquía de huesos teniendo en cuenta el rango de movimiento previsto. En 2026, lo crucial fue la implementación del Soft-Constraints Solver directamente durante el skinning. Esto elimina el efecto de "puente de chocolate" en los codos con poses extremas sin necesidad de corregir manualmente el Weight Painting. Para equipos indie, el soporte del Esquema USDZ v3 es crítico: la exportación de avatares AR para VisionOS ocurre en un solo clic manteniendo un pool comprimido de BlendShapes.
AccuRig (Reallusion) versión 2.1 evolucionó de una utilidad para Character Creator a un servicio independiente de retargeting. El principal dolor de cabeza de años anteriores —la pérdida de volumen del pecho en modelos femeninos en T-pose— se resolvió con la implementación de Volumetric Preservation Maps. El algoritmo escanea la malla original, crea una envoltura invisible de densidad y asegura que la distancia entre los huesos no colapse la geometría. Un cambio importante de 2026 fue renunciar a la dependencia del renderizado en la nube para generar mapas de pesos. El motor local TensorRT permite obtener un Rig listo en aproximadamente 14 segundos en hardware clase RTX. Apareció un detector inteligente de ropa: el sistema genera automáticamente una segunda capa de física de colisión para largas capas, evitando que la tela atraviese los muslos al caminar.
Mixamo, durante mucho tiempo el estándar de velocidad, sufrió una transformación tras la integración de Adobe Sensei Gen-3. Ahora ya no es una biblioteca de MoCap, sino un generador de animaciones contextuales. Se carga una pose T-Pose estática y la red completa las articulaciones faltantes (por ejemplo, los dedos) si no existen en el modelo. Pero lo principal es Semantic Motion Tagging. Al cargar el modelo, se escribe un prompt: "guarda cansado, armadura pesada". El sistema adapta la amplitud de los pasos y el centro de masa del personaje según sus dimensiones. En el contexto de proyectos Unity URP/HDRP, esto ahorra horas de configuración de Root Motion. Sin embargo, surgió un matiz de licenciamiento: los bancos de activos comenzaron a marcar los ciclos generados por IA con una bandera separada en los metadatos GLB, lo que requiere verificar la compatibilidad con la política de los dueños de las plataformas antes del lanzamiento.
Las herramientas integradas en los DCC también mejoraron. Maya HumanIK recibió un plugin Biomech Predictor que bloquea ángulos imposibles de las articulaciones basándose en el tipo de complexión. Unreal Engine Control Rig en la versión 5.6 aprendió a realizar deformación inversa: al cambiar la forma de la metáfora final (controlador), se deforman físicamente los vértices de la piel en tiempo real, omitiendo el recálculo de todo el grafo.
La conclusión de la evolución es simple: una herramienta moderna evalúa no solo dónde colocar un hueso, sino cómo ese hueso debe respirar dentro del volumen muscular de un modelo altopoligonal específico.
Anatomía de un rigging moderno de ML: desde la nube de puntos hasta los pesos con topología limpia
En las canalizaciones (pipelines) del 2026, el rigging mediante redes neuronales dejó de ser magia de "un solo clic" y se transformó en una cadena estricta de conversión de datos crudos a un modelo de deformación optimizado. La fuente suele ser una geometría densa procedente de fotogrametría o Gaussian Splatting, convertida a través de algoritmos de nueva generación MV-HMR (Recuperación de Malla Humana Multivista). La tarea principal en esta etapa es transformar una caótica nube de polígonos con proporciones implícitas en una malla predecible con escala correcta antes de pasar al skinning.
El primer eslabón crítico es la retopología sin pérdida de volúmenes. Herramientas modernas como AutoQuad v4 o TopoGen-X utilizan transformadores difusivos para construir una malla dominada por cuads sobre un escaneo altopoligonal. A diferencia de los enfoques de años anteriores, los modelos actuales están entrenados para preservar aristas duras (hard edges) de las articulaciones ya en la fase de generación del UV mapping. Esto permite evitar el clásico efecto "mermelada", donde los tejidos blandos fluyen unos dentro de otros con una rotación mínima del hueso. Para los estudios independientes, el factor clave ha sido la posibilidad de ejecutar esta etapa localmente en aceleradores de nivel RTX 5070+ gracias a la optimización de los modelos bajo precisión INT8.
El siguiente paso es la extracción de la pose. En lugar de la asignación manual obsoleta de la T-pose, se aplica una arquitectura de Redes de Canonización de Pose (Pose Canonicalization Networks). La red neuronal analiza la geometría de entrada, encuentra los puntos anatómicos de referencia (puntos ACR) y endereza forzadamente al personaje en A-pose (neutral para los motores de juego). Aquí mismo ocurre la corrección automática de la topología alrededor de los músculos deltoides y las articulaciones de la cadera —zonas de máxima tensión de la piel. Los errores en esta etapa son fatales: un ángulo incorrecto del hombro provocará el colapso de los pesos durante la animación de captura de movimiento.
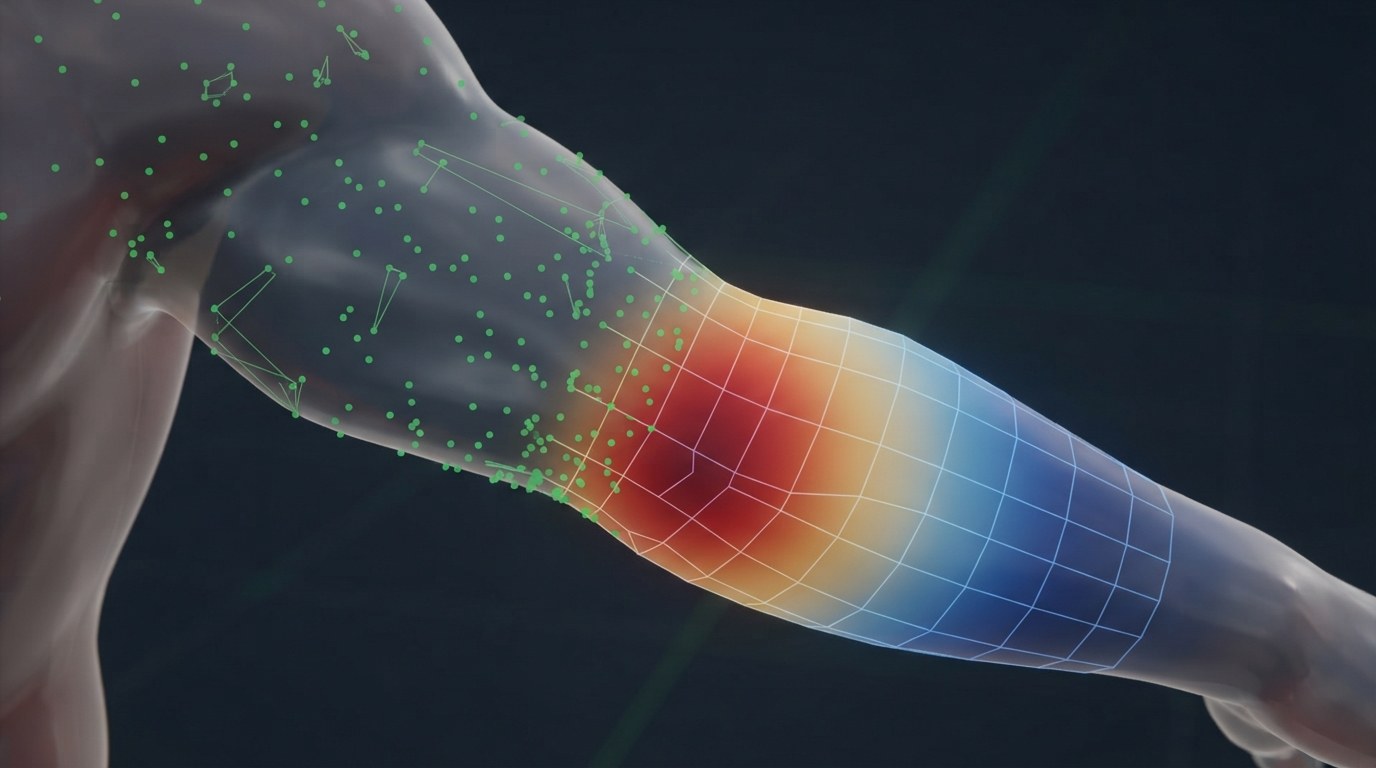
La etapa final es el cálculo de los pesos de skinning. En 2026, el estándar de facto es un método híbrido: Difusión de Calor + Mezcla Neuronal (Heat Diffusion + Neural Blending). El hit-test tradicional de huesos proporciona una distribución base de la influencia ósea, pero deja artefactos en los dobleces de los codos. La capa generativa de la red dibuja los pesos para imitar el comportamiento de la grasa subcutánea y las fascias. El requisito más importante de las tiendas Google Play y App Store hoy en día es la estabilidad de FPS, por lo que el setup final debe cumplir con el límite de Costos de Skinning GPU:
- Mobile High-End (iPhone 17 Pro / Android Flagship): no más de 0.3–0.4 ms por personaje;
- PC/Console Indie: control estricto de la cantidad de huesos influyentes (generalmente hasta 4 por vértice), recorte de pesos débiles por debajo del umbral 0.01 automatizado mediante el script CleanWeights AI.
Se presta especial atención a la compatibilidad con software DCC. El FBX exportado pasa por verificación a través del Validador USDZ 2026. Si la red detecta geometría non-manifold o normales invertidas en zonas de deformación, el proceso regresa a la etapa de retopología. Para personajes procedurales se utiliza Rigging en Capas (Layered Rigging): la columna vertebral base se genera una vez, y las extremidades (tentáculos, colas, implantes cibernéticos) se añaden como nodos gráficos independientes con sus propios blend shapes precalculados para la compresión de volumen.
El resultado de este pipeline es un rig limpio, listo para recibir datos de Motion Matching o animación creada mediante prompt de texto. La ausencia de vértices duplicados, cuadrángulos perfectos en las articulaciones y una distribución de pesos físicamente plausible permiten renderizar mímica compleja en tiempo real incluso en dispositivos de gama media, lo cual es crucial para el mercado de videojuegos móviles del ciclo de hardware actual.
Animación facial de nueva generación: modelos difusivos locales frente a API en la nube
Para 2026, la mímica dejó de ser una "sobrecarga costosa" y se convirtió en un requisito básico para mantener la atención en los juegos narrativos. Los jugadores están acostumbrados al fotorrealismo de Unreal Engine 5.4–5.5 y a la profundidad emocional generada a partir del audio. Los desarrolladores tuvieron que elegir entre dos paradigmas: ejecutar modelos pesados como Audio2Expression o Emotion ControlNet directamente en el dispositivo (On-Device) por privacidad y latencia cero, o utilizar API en la nube basadas en streaming con pago por tokens y segundos de renderizado.
Enfoque local: Diffusion On-Device y optimización mediante LCM
Ejecutar redes neuronales dentro del ciclo del juego ha sido posible gracias a la implementación de Latent Consistency Models (LCM) y decodificación especulativa directamente en tiempo de ejecución de los motores. En Unity Sentis 2.3 y nuevos plugins de NVIDIA ACE, el modelo local de rigging facial funciona como un grafo computacional asíncrono. El pipeline principal es el siguiente: el buffer de audio se captura con el micrófono, se limpia de ruido con filtros DSP integrados y luego se alimenta a la cabeza codificadora tipo transformer. Esta genera los pesos de los Blendshapes no fotograma a fotograma, sino en segmentos completos de curvas de animación.
La principal ventaja es el control total sobre los datos. Para estudios independientes esto es crítico debido a los requisitos de Apple App Store Transparency y GDPR: los datos biométricos faciales nunca abandonan el dispositivo. Sin embargo, el precio es una gestión agresiva de la memoria. Para evitar bloqueos durante las conversaciones, los equipos utilizan la técnica "Warm-up Pools": durante la carga del nivel, la GPU calienta los núcleos tensoriales con corridas vacías del modelo para que la primera llamada de inferencia tarde predeciblemente entre 18 y 22 milisegundos. Un error típico aquí es intentar procesar la red full-face cada frame. La práctica correcta de 2026 es ejecutarlo cada 3 o 4 frames con interpolación posterior mediante splines de Animation Rigging.
API en la nube: Streaming Morph Targets y compromisos de red
Servicios en la nube como Replica Studios Live o endpoints especializados de Epic Online Services ofrecen calidad de estudio sin sobrecargar la tarjeta gráfica del usuario. El modelo en el servidor analiza el espectrograma de la voz del actor de doblaje y devuelve un JSON listo con valores de ARKit blendshapes o un rig personalizado a través del protocolo WebRTC DataChannels.
En 2026, el factor clave para elegir la nube fue el soporte de flujos UDP con Corrección de Errores hacia Adelante (Forward Error Correction). Esto permite transmitir paquetes de morph-targets incluso ante pérdidas de paquetes en internet móvil. El principal problema es la demora (RTT). Si el RTT supera los 80 ms, los labios empiezan a retrasarse respecto al discurso, lo que destruye el efecto de presencia. La solución fueron los buffers predictivos: el lado cliente recibe el texto de los subtítulos medio segundo antes que el audio, construye un mapa probabilístico de fonemas y abre anticipadamente la boca del personaje. Tan solo llega el paquete real de pesos del servidor, el sistema simplemente corrige las desviaciones.
Hibridación de shape keys y retargeting
El estándar actual en proyectos AAA es híbrido. Un modelo local ligero procesa las emociones de primer orden (sorpresa, ira) instantáneamente. La nube se conecta como un proceso en segundo plano para transmitir sutiles matices articulatorios propios de un idioma de doblaje específico. La malla final se forma mezclando estos flujos a través de Post Process Material Layering. Al mismo tiempo, el paso final siempre recae en un rig tradicional basado en joints: la red neuronal solo entrega los targets de forma, mientras que la física de tejidos, colisiones de pelo y motion capture corporal terminan de darle forma hasta alcanzar un estado Ready for Render completo.

Integración en Unreal Engine 5.5+: Live Link, Control Rig y Post-ML cleanup
En el ecosistema de Unreal Engine 5.5+, el pipeline de rigging basado en redes neuronales y generación de animaciones ha pasado definitivamente de ser una herramienta experimental a convertirse en un estándar de desarrollo. La tarea clave en esta etapa no es solo importar los datos de los modelos generativos (por ejemplo, Motion Diffusion o solucionadores IK basados en Transformers), sino integrarlos sin fisuras en el ciclo de producción con la posibilidad de iteraciones sin pérdida de calidad.
Etapa 1: Transporte de datos a través de Live Link
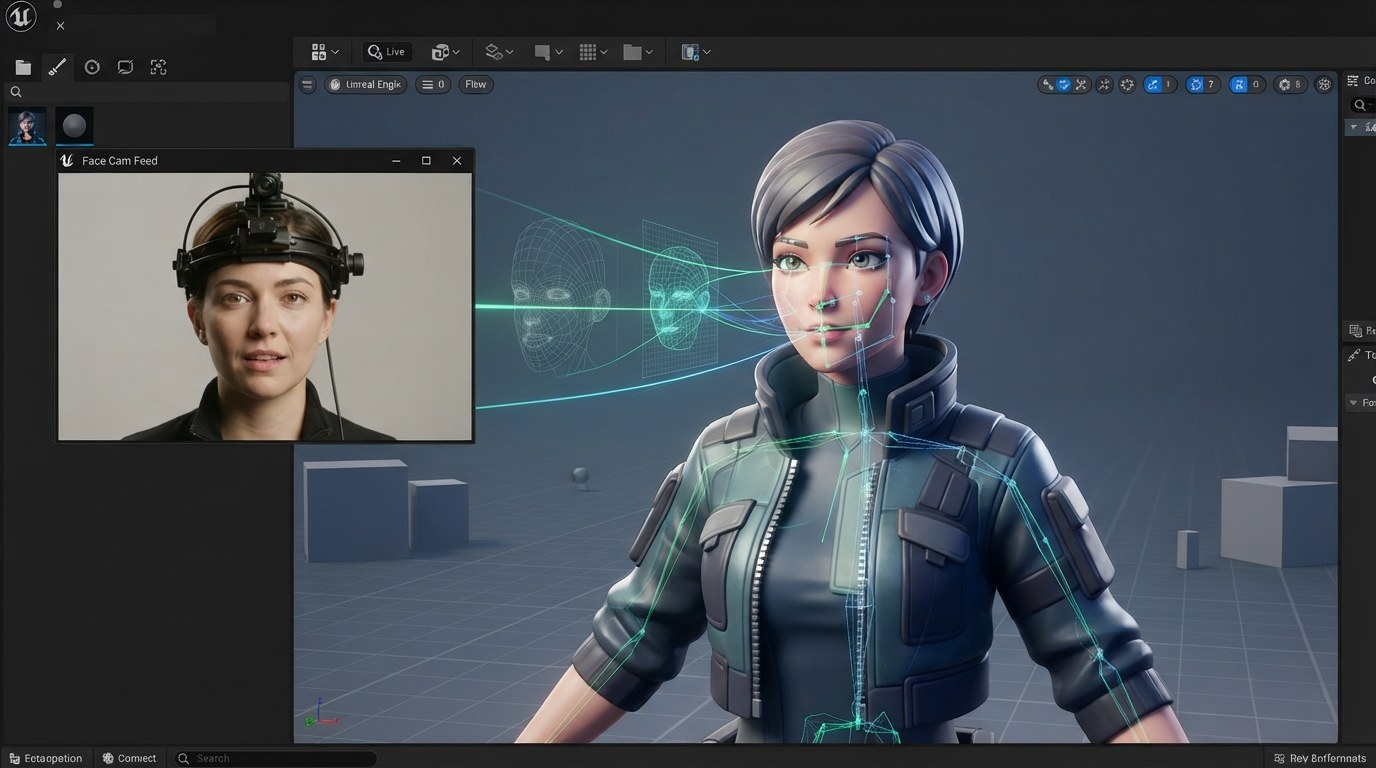
Los servicios modernos de ML para captura facial (FaceTrack AI) y captura inercial del cuerpo ahora transmiten los datos directamente mediante el protocolo Live Link. A diferencia de los enfoques antiguos que utilizaban grabación FBX, el uso de Live Link Subject permite ver el resultado en el editor de UE en tiempo real. Para personajes personalizados es crucial utilizar un Live Link Preset con remapeo de huesos (Bone Remap). En 2026, la mayoría de los SDK generan curvas extendidas (Curves) junto con las rotaciones de las articulaciones. Estas curvas deben mapearse inmediatamente sobre los parámetros de vuestro Animation Blueprint, omitiendo la fase de baking en una pista de acción limpia del secuenciador. Esto preserva la naturaleza no destructiva del original.
Etapa 2: Normalización a través de Control Rig Las animaciones generadas por IA a menudo contienen microtemblores o artefactos de "penetración" de extremidades a través de la geometría debido a una estimación imprecisa de las características masa-inerciales. En lugar de corrección manual fotograma a fotograma, se aplica un Control Rig de dos niveles:
- Capa de Pre-procesamiento: Aquí se aplican nodos utilitarios para filtrar el ruido de la señal entrante de Live Link. Se utiliza suavizado mediante funciones Quaternion con una ventana adaptativa para no matar la agudeza de los golpes.
- Capa de Fix-up: En este nivel operan los fijos de Cinemática Inversa (IK). Si el modelo ML falló en la longitud del paso o la altura del salto, las piernas procedimentales de MetaHuman o un Leg Solver personalizado adhieren los pies a la superficie de colisión (Floor Snap) justo durante la reproducción del borrador.
Etapa 3: Retargeting y capas de corrección
Al transferir desde un meta-rig genérico a un esqueleto específico, se utiliza el nuevo sistema Retarget Manager con soporte para Per-Bone Properties Override. Sin embargo, la herramienta principal aquí son los Animation Layers. Los datos de IA se colocan en la capa base (Base Pose). Encima se superponen capas correctoras (capas Aditivas/Override) que son escritas manualmente por el animador sobre la base de la máquina. En UE 5.5, el modificador Stacked Blend Inertial Node permite introducir gradualmente ediciones manuales solo en momentos de aceleración extrema, donde los algoritmos tienden a cometer errores de peso.
Etapa 4: Post-ML Cleanup en Sequencer
Cuando el borrador es aprobado, se envía al Level Sequence. La práctica actual implica renunciar a la limpieza total del mocap. El Editor de Curvas (Curve Editor) ahora posee un Denoiser ML integrado que analiza el espectro de frecuencias de la pista y elimina el ruido de alta frecuencia por encima del umbral de percepción de la biomecánica humana, conservando al mismo tiempo las intenciones de baja frecuencia del actor. Para la animación facial es obligatorio aplicar el nodo Jaw Wiggle Correction dentro del AnimBP, ya que los modelos difusivos tienden a abrir exageradamente la boca en vocales.
Optimización para tiempo real
La etapa final antes de exportar al juego es Baking to Control Rig. Vuestra horneáis los pesados cálculos procedimentales y los gráficos de corrección en claves estáticas, pero manteniendo la jerarquía de Controles. Esto brinda a los diseñadores de juegos la capacidad de cambiar puntualmente la amplitud de las emociones o la velocidad del golpe de un arma incluso después de que la intensa fase de neuro-generación haya concluido, garantizando un equilibrio ideal entre la velocidad de producción y la calidad de la animación hecha a mano.
Unity 6 y Sentis: llevando la lógica de facial mocap y animación procedural al runtime
La transición de Unity a la arquitectura Unity 6 con una pila de renderizado unificada (URP/HDRP) ha consolidado definitivamente las redes neuronales como una herramienta estándar en el pipeline de animación. Un papel clave lo juega Sentis Runtime AI, que permite ejecutar inferencia de modelos ONNX optimizados directamente dentro del player sin los costos de sobrecarga de IPC y serialización de datos entre CPU/GPU. En el contexto del rigging, esto significa renunciar a "bakear" todas las variantes de movimiento y pasar a la síntesis dinámica de poses.
La arquitectura de la solución se construye en torno a dos componentes: Skeleton Graph API para manipular la jerarquía de huesos y un Grafo de Deformaciones orientado a Compute. En lugar de procesar cada fotograma un pesado skinning sobre cientos de influencias óseas, el motor utiliza un ligero modelo de corrección de desplazamientos (Delta Model). Este toma como entrada los ángulos actuales de las articulaciones y los datos de salida del solver IK, devolviendo un vector de deltas para el buffer de vértices o correcciones a los cuaterniones. Esto es críticamente importante para plataformas móviles, donde el presupuesto de instrucciones del vertex shader está estrictamente limitado.
Para la animación facial, la práctica del 2026 dicta un enfoque híbrido. Los modelos pesados de generación de emociones funcionan offline en el editor, creando una biblioteca de blendshapes base. En tiempo de ejecución, a través de Sentis, se lanza una compacta red regresional de hasta 5–10 MB. Su tarea es mezclar estas formas según el ángulo específico de la cámara y la iluminación de la escena. El modelo aprende a compensar las distorsiones de la malla durante giros extremos de cabeza que no fueron cubiertos por los clips de Mocap. La integración ocurre mediante Animation Jobs personalizados, ejecutados en el backend DOTS Job System, lo que garantiza seguridad de hilos y evita picos en el Main Thread Time.
Los requisitos modernos de las tiendas de aplicaciones imponen limitaciones al consumo de energía. El uso de la variante GPU de Sentis requiere un manejo cuidadoso de las barreras de recursos. El patrón recomendado es la ejecución asíncrona de núcleos GPGPU de la red neuronal dos fotogramas antes de la visualización real del personaje. Los datos se escriben en un RWStructuredBuffer intermedio, que luego es capturado sin fisuras por el Pass final de Character Rendering. Para prevenir micro-lags en dispositivos con memoria débil, se utiliza un Streaming Assets Bundle con compresión LZ4 de los modelos, cuya descompresión se delega al gestor de memoria nativo del runtime.
La especificidad de Unified Path en Unity 6 permite integrar tales cálculos directamente en los SubTarget de los gráficos de materiales. Cada vez más desarrolladores renuncian a transferir morph targets listos desde la CPU. En su lugar, la etapa Vertex del shader accede a los pesos tensoriales cargados en Texture3D o ByteAddressBuffer. Esto abre el camino al estiramiento procedural de la piel (wrinkle generation), donde la amplitud de las arrugas se calcula por la red neuronal basándose en el estiramiento local de las bandas UV, en lugar de un valor global de BlendShape.
Un aspecto importante sigue siendo la calibración para diferentes arquitecturas de chips. Los modelos entrenados en datasets Mixamo o grabaciones internas de Rokoko requieren Post-training Quantization (PTQ) hasta Int8/FP16. Las herramientas de Unity proporcionan Modules de Profiler para analizar el tiempo de ejecución de la inferencia ANN por separado de la física y el render. Un error típico de integración del 2026 es intentar ejecutar un full-body physics solver junto con una red generativa en un solo núcleo NEON del SoC móvil. La salida correcta es delegar parte de los cálculos al DSP/NPU del smartphone a través de los proveedores de aceleración hardware de Sentis, dejando la CPU libre para la lógica del gameplay.
Así, Sentis deja de ser un complemento experimental. Se convierte en una capa de abstracción entre los datos crudos de captura de movimiento y el modelo final de alta poligonización, asegurando la suavidad de la interpolación allí donde el tracking spline clásico es físicamente incapaz de adivinar la biomecánica del tejido o el hipertono muscular.
Godot 4.4+ y soluciones abiertas: tokens VRM, bots de rigging con Llama.cpp
En el sector independiente, Godot se ha consolidado como el núcleo para la creación rápida de prototipos de personajes gracias a la rama 4.4+. En esta versión, Skeleton3D obtuvo soporte nativo para Heat-Map Weighting y una mejora en el retargeting mediante RetargetModifier con compensación de proporciones sin que las muñecas "floten". Para los juegos móviles esto es crítico: el presupuesto para el skinning está limitado a un solo ciclo del sombreador de vértices con el objetivo de alcanzar los 60 FPS en Quest 4 y en chips Android promedio de 2025–2026. El pipeline se construye alrededor del rigging automático mediante bots open-source, donde el inferencia local se ha convertido en el estándar de facto.
La herramienta central son los bots de rigging de Llama.cpp. Los desarrolladores integran modelos fine-tuned de la familia Qwen 2.5 o Mistral-Nemo (hasta 7B de parámetros) para predecir la jerarquía de huesos a partir de la nube de puntos del mesh. El bot recibe un archivo .glb de hasta 15 MB, analiza la densidad de la topología y entrega una plantilla lista de Bone Map junto con poses base T/A/Pose. El proceso toma entre 8 y 20 segundos en un Mac M3 Ultra o PC RTX clase 50. La ventaja clave es la ausencia de pagos por API en la nube; el modelo se ejuta localmente, lo que permite manejar proyectos bajo NDA. Tras la generación, el script aplica automáticamente Smart Weights de serie en Godot, descartando pesos por debajo del umbral de 0.01 para reducir las omisiones de draw call.
La exportación de assets para avatares se basa en la evolución del estándar VRM 1.0, que ahora se lee correctamente con el nodo GLTFDocument sin trucos. Sin embargo, la especificidad del lanzamiento móvil exige transitar hacia la concepto de tokens VRM. En lugar de morphs Blend Shapes pesados, la aplicación transmite tokens binarios de expresión (coeficientes de peso de visemes), que se reconstruyen ya en el dispositivo del usuario mediante un Compute Shader simple. Esto reduce el tamaño del build en un 40%: en vez de transmitir todo el conjunto de meshes personalizados, el cliente carga únicamente la base neutra y un diccionario de llaves de animación.
Para la animación procedural de caminata e interacción de manos se utiliza la combinación de AnimationMixer con nodos IK y gráficos ligeros de Motion Matching. Dado que un MM completo es demasiado pesado para OpenGL ES 3.0, en Godot se emplea un enfoque híbrido. La red neuronal genera un borrador de Root Motion en forma de curvas TransformPath offline. En el dispositivo funciona una State Machine que mezcla estos clips con correcciones de Cinemática Inversa en tiempo real. Los parámetros de entrada provienen del Contextual Actions Predictor —un modelo ONNX compacto de unos 4 MB— que predice la intención del jugador (golpe, esquiva) 120 ms antes de completarse la animación actual.
Los errores típicos del pipeline incluyen ignorar Scale Compensation al pasar de Blender a Godot, lo que rompe la longitud de las extremidades en humanoides no estándar. La solución es congelar rigidamente Apply Scale antes de la exportación y usar Remesh Modifier Quad Only para unificar la densidad de la malla bajo el Skinning Aggregator. El segundo problema es el desbordamiento del Uniform Buffer Object en chips Adreno débiles. El límite de huesos activos se mantiene estrictamente en 64 unidades por mesh. Todo lo demás se traslada a Mesh Instances o se hornea en atlas de texturas de pesos de huesos mediante Texture-based Skinning, disponible en los renderizadores Forward+ y Mobile a partir del parche 4.4.1.
La optimización culmina con el perfilado a través de GPUPerformanceMonitor. El objetivo es no superar los 0.4 ms en la deformación del esqueleto durante la carga de la escena. Si el indicador es superior, se aplica cuantización de pesos al nivel half-float y un Bake Lightweight Vertex Cache agresivo dentro del Import Dock. Este stack tecnológico permite a un desarrollador solitario publicar personajes personalizables, cuyo calidad se acerca estrechamente a las soluciones AAA de años anteriores, manteniendo la tasa de fotogramas objetivo en dispositivos masivos.
Optimización para tiendas móviles: límites de peso, cuantización y batching de huesos
En 2026, las tiendas siguen manteniendo marcos estrictos sobre el rendimiento del renderizado. App Store (iOS 19+) y Google Play (Android 15+, API 34+) utilizan perfiles de limitación agresiva cuando se superan los límites de tiempo de GPU-skinning por fotograma. Para proyectos con rigging basado en redes neuronales, esto significa pasar de datos "bonitos" a pipelines estrictamente regulados. El principal problema de los setups pesados es la cantidad de pesos que influyen en un vértice y la densidad de las claves de animación.
Restricciones estrictas de peso de vértices
El estándar de la industria para plataformas móviles permanece invariable: máximo 4 huesos por vértice (4 weights). Las redes neuronales suelen generar deformaciones suaves, distribuyendo la influencia entre 8–12 huesos. En el editor Unity 2026 LTS o Unreal Engine 5.5+ es necesario aplicar forzosamente Weight Limiting SOP antes de la etapa de exportación FBX/USDZ. El algoritmo no debe simplemente recortar las influencias débiles, sino renormalizar las cuatro mayores magnitudes restantes. Esto previene artefactos de colapso de geometría en dispositivos Apple Silicon A19 Pro y Snapdragon Elite X2, donde los controladores descartan paquetes de vértices que violan la especificación.
Cuantización de curvas de animación
La generación mediante Difusión de Movimiento (Motion Diffusion) produce pistas densas de cuaterniones. Cargar estos activos en memoria consume el presupuesto de VRAM en segundos. El enfoque moderno requiere aplicar cuantización canal por canal antes del baking:
- Posiciones (Translation): compresión a half-float (FP16) con un error permisible de 0.1 cm.
- Rotaciones (Rotation): uso de formatos comprimidos como Quaternion Compression (por ejemplo, formato Dropbox Normals), empaquetando datos en bytes en lugar de float32.
- Escala (Scale): exclusión total de las pistas si es constante, o restricción estricta a interpolación lineal sin splines cúbicos.
En Godot 4.4 es relevante el plugin Animation Retargeting & Compress, que analiza automáticamente la entropía de la curva y elimina claves redundantes, dejando solo aquellas que cambian la dirección de la derivada.
Batching de mallados esqueléticos e Instancing
Las redes neuronales permiten generar animación variativa de multitudes (crowd). Sin embargo, cada Skinned Mesh Renderer individual rompe el procesamiento por lotes (Batching). Para mantener FPS por encima de 60 en chips medianos, se utiliza la tecnología Texture-based Skinning (Bone Textures). En lugar de transferir una matriz de matrices de huesos a través de Uniform Buffer Object (UBO) desde la CPU, las matrices se graban en una textura RGFloat de alta resolución. El shader las lee según el ID del vértice. Esto permite combinar cientos de personajes en una sola llamada Draw Call mediante GPU Instancing. En UE5, la herramienta clave ha sido Niagara + Control Rig, donde se puede instanciar incluso estados únicos de drivers RBF, transmitiendo parámetros de morfes a través de Structured Buffers.
Restricciones en tiempo de ejecución y LOD de huesos
Para rostros se aplica Bone LOD. A distancias superiores a 10 metros, los huesos mandibulares, oculares y de mímica fina se desactivan mediante un script Runtime Constraint. Su transformación se congela y la deformación se transfiere a las formas parentales blendshape. Esto es crítico para Quest 4 y Vision Pro, donde la unidad computacional está ocupada con foveation. También se ha vuelto obligatorio usar Optimize Game Objects en la configuración de importación: la jerarquía debe ser aplanada (Flattened), eliminando nodos nulos intermedios que los modelos neuronales suelen añadir para estructurar el espacio.
La fase final de verificación es Asset Bundle Validation en la consola de build. Si el tamaño total de las pistas crudas de animación excede los 20 MB por personaje, el algoritmo de generación se considera desequilibrado y se envía a reentrenamiento con el regularizador Sparcity Loss.
Barrera de Calidad y trampas: cuando la IA entrega basura y cómo construir una lista de verificación de QA
En 2026, el rigging automático a través de redes neuronales dejó de ser un experimento, pero no se convirtió en magia. Herramientas como AutoRig Pro ML o los pipelines nativos en Blender 4.5 y Unreal Engine 5.6 ofrecen una base excelente en segundos, sin embargo, la exportación "cruda" sigue rompiendo el juego durante la integración. El principal riesgo es la confianza falsa del pipeline. Si aceptan el resultado sin un filtro estricto, la deuda técnica se acumula exponencialmente con cada nueva porción de assets.
Errores críticos del skinning automático y la jerarquía
- Doble transformación (Double Transform). El problema más frecuente al generar un Control Rig desde video de referencia (Motion-to-Rig). La red puede vincular la geometría a los huesos y dejar activas las formas correctivas Blendshapes que ya están incluidas en la posición del hueso. Como resultado, la malla tiembla o se estira al doble. Verifique: congele las deformaciones de los huesos en T-pose; si la malla se deforma sola — busque shapes innecesarios o modificadores Skin después del Morpher.
- Parenting "fantasma". La IA a menudo crea nodos null intermedios para compensar ejes, olvidando establecer las banderas Inherit Scale/Rotation en False. Durante la animación de correr, las piernas comienzan a escalarse junto con el torso. La lista de verificación requiere pasar por todas las articulaciones con una utilidad de chequeo de escala (World-Space Unit Check) antes del skinning.
- Colapso de pesos en las uniones. Las redes generativas les gusta dibujar bordes duros (Hard Edges) donde se necesita suavidad. Codos y hombros reciben pesos cero en los polígonos de flexión. En Godot 4.4 esto provoca rupturas de la malla al usar corredores físicos JiggleBone.
- Inversión de normales bajo peso. Durante una transferencia agresiva de pesos desde una biblioteca (Weight Transfer AI), las cavidades internas de guantes o armadura pueden invertirse solo en ciertos ángulos de rotación de la muñeca.
Métodos de pulido final manual
La transición del borrador a producción le toma al artista técnico unos 30–40 minutos por personaje, si sigue un protocolo rígido. Primero se realiza la limpieza de topología de pesos. Utilice herramientas tipo Quad Weight Painting: traduzca forzadamente las zonas de deformación en cuadrados de distribución de peso (100-0, 75-25, 50-50), cortando valores aleatorios como 33.3% o 8% que genera el modelo ruidoso.
La segunda etapa es la estabilización del centro de masa. El Motion Capture neuronal da un movimiento vivo, pero sucio en la pelvis (Hips). Aplique un filtro de promedio móvil (Windowed Average Filter) exclusivamente a la translación Y del hueso raíz, dejando X y Z afilados para las respuestas del gamepad. Esto eliminará el efecto de "caminar ebrio", característico de datos crudos del Apple Vision Pro SDK 2 o Rokoko Video.
Especificidad de los shape keys en tiempo real (Blendshapes)
Si la animación facial fue generada por modelos Audio-to-Face, controlen la cantidad de objetivos activos. Las GPU modernas permiten mantener cientos de shapes, pero los drivers LOD runtime los recortan. Horneen microexpresiones (peso inferior al 5%) en mapas de textura de compresión Normal Offset, en lugar de animación vértice. Para Meta Quest 4 y PS VR2 Remix límiten estrictamente a 32 morfos activos por frame.
Lista de verificación de recepción (Gatekeeper List) Antes de hacer commit del asset en Perforce/Git, asegúrense de que:
- La escala del esqueleto sea estrictamente 1.0 / 1.0 / 1.0 en coordenadas mundiales.
- No haya escala negativa (Negative Scale) en ningún hueso de la jerarquía — esto romperá el cálculo de normales en renderizados Forward+.
- El Root Motion esté extraído como curva separada del Asset de Animación para soportar Network Replication en UE5.
- El puntaje Skinning Quality Score (métrica integrada Unity 6 Muscle Group Solver) sea superior a 90 puntos sin correcciones manuales en más de 15 articulaciones.
La IA acelera la producción, pero no entiende el contexto del juego: clipping de capas en puertas estrechas o la necesidad de agarre IK-por-la-pata al trepar. La última palabra siempre la tiene el TA, que conoce el precio de estos errores en milisegundos de FPS.
Economía del estudio: cálculo del ROI al reemplazar un rigger interno por una suscripción a una herramienta SaaS
En 2026, la pregunta de «contratar a un especialista o comprar software» para tareas de animación de personajes se ha transformado en una elección entre gastos de capital y operativos. El mercado del rigging basado en redes neuronales ofrece soluciones maduras capaces de generar un esqueleto básico (FK/IK), pesos de vinculación (skinning) y poses básicas en segundos. Sin embargo, reemplazar a un empleado clave por una suscripción en la nube requiere un cálculo frío de la rentabilidad de la inversión (ROI). Ignorar los costes ocultos de integración suele llevar al desbordamiento del presupuesto.
Modelo de costes interno (In-house). En 2026, el salario mediano de un artista técnico senior de personajes (Senior Character TD/Rigger) en Europa del Este asciende a unos $3500–$4500 antes de impuestos. Con las contribuciones sociales y los gastos indirectos, el estudio gasta aproximadamente $5500 mensuales por especialista. Un empleado no solo trabaja en la creación del rig, sino también en el soporte del pipeline: adaptación de assets al cambiar versiones del motor (Unity 6.x LTS con Entity Component System v2.0, Unreal Engine 5.5+), escritura de utilidades de automatización y corrección de errores de exportación FBX/USD. La IA cubre actualmente estas tareas solo parcialmente.
Modelo de suscripciones (SaaS AI Rigging). Las plataformas modernas de generación de animaciones y rigging funcionan bajo un modelo de consumo de tokens o tarifa fija por puesto de trabajo. La factura media de un servicio avanzado con acceso API para procesamiento por lotes de activos oscila entre $150 y $400 por usuario al mes. Además, el coste de generar una malla compleja depende del número de polígonos. Para un proyecto de una indie studio mediana (alrededor de 30 personajes únicos más variaciones de ropa), la factura mensual puede alcanzar los $800–$1200, incluyendo el overhead por iteraciones repetidas debido a artefactos en los pesos.
Cálculo del punto de equilibrio. Una comparación directa muestra la ventaja de la IA: $1200 frente a $5500. Pero la fórmula del ROI debe incluir el tiempo de implementación. Integrar una API externa en su herramienta editora (Editor Tooling) le toma a un programador mid-level (~$3000/mes) unas dos semanas —esto son costes únicos de ~$1500—. Posteriormente, se considera la velocidad del flujo de trabajo. Si un rigger interno hace un modelo complejo en 2 días, y la IA genera un borrador en 3 minutos, la ganancia de tiempo es colosal. Sin embargo, el pulido final de las formas de las articulaciones (orientación de joints) y la corrección de dobles rotaciones tras el skinning automático siguen requiriendo mano de obra junior ($1200/mes).
Riesgos ocultos e impuestos sobre datos. La principal trampa de 2026 es la dependencia de la nube. Durante picos de carga, la latencia de los servicios aumenta, bloqueando el trabajo del departamento de arte. Además, los datos exportados mediante IA pueden contener topologías de pesos no optimizadas para plataformas móviles (Quest 4, Vision Pro 2). Optimizar ese rig manualmente consume hasta el 40% del tiempo ahorrado. Es crucial el aspecto jurídico: asegúrese de que la licencia SaaS le transfiere derechos totales sobre la malla resultante (output mesh rights) libre de regalías (royalty-free), de lo contrario tiendas como Google Play o App Store podrían rechazar el build durante la auditoría del origen de los activos.
Estrategia híbrida óptima. El mejor indicador de ROI se obtiene renunciando a contratar un segundo Senior-rigger a favor de combinar un Junior TA + suscripción SaaS. La red neuronal entrega la base en minutos, el junior limpia la malla y configura la física de telas (Chaos Cloth / NVIDIA Flex), mientras que el Senior solo se involucra para crear setups faciales complejos (Blendshapes) y controladores procedimentales. Este esquema reduce la masa salarial en un mínimo del 35%, manteniendo el control de calidad. El máximo ahorro se alcanza en la pre-producción, cuando es necesario prototipar rápidamente decenas de variantes de paquetes de movilidad para verificar hipótesis de meta-juego.