

2026–2027 年市场现状:为何手工绑定已成奢侈品
到 2026 年底,行业彻底重新审视了技术美术的角色。手工蒙皮和从基础“骨架”构建骨骼层级已经转变为仅适用于 AAA 主角或特定机械系统的高端服务。对于独立工作室、外包团队和移动开发者而言,传统流程已不再是大众实践。其根本原因在于游戏设计师原型制作速度与动画部门处理能力之间出现了巨大的差距。
商店对内容更新频率的现代要求——尤其是 Unity(6.x 版本)和 Unreal Engine 5.5/5.6 上的 LiveOps 游戏领域——决定了必须每周发布新皮肤、表情和交互功能。在资深绑定师供不应求且薪酬持续飙升的情况下,对每个资产进行手工操作在经济上变得极具毒性。工作室根本无法允许让一名高水平专家花费两三个工作日来准备次要 NPC 或可变换的自定义物品。
推动这一变化的关键因素是引擎内部集成的 AI 模块。MetaHuman Animator 2.0 不再是仅用于写实风格的工具;由于几何匹配算法得到改进,其核心现在被广泛用于即使在风格化模型上也能进行迁移重定向。Godot 4.5 的本地神经网络插件支持允许在编辑器中根据文本描述变形区域(如“肘部柔软弯曲”、“装甲硬锁定”)生成权重贴图 (skin weights)。这将基础准备阶段从数小时的衬垫挑选和镜像复制缩短至几分钟。
经济模式已从按工时付费转向按最终造型质量付费。2026 年的管线如下:概念艺术家提供 ZBrush 阻值或 High-poly 扫描,ML 模型生成草稿绑定和初步运动合成动画,而技术美术只是作为关节插值错误的校正者。Autodesk Character Generator AI 和基于 Transformer 的开源解决方案等工具在创建骨骼结构阶段就能理解布料物理,在人类通常会在紧身衣服上出错的位置自动放置碰撞胶囊。
对于移动开发而言,针对 2026 年 Snapdragon Elite 系列芯片和 Apple A19 Bionic 的优化成为关键因素。动画生成神经网络现在已训练以考虑实时限制:它们输出无多余关键帧的旋转曲线,并直接建议网格影响的最佳 LOD 级别。如果过去程序化绑定被视为以质量换取速度的妥协,那么今天拒绝使用它意味着在补丁发布节奏上处于劣势。玩家期待所有地区同步季节性内容,而依赖手工顶点权重的团队在生理上无法完成冲刺任务。
在图形外包的背景下,这导致了输入数据的标准化。客户不再要求完整的 .rig 文件。相反,传递的是干净的 T-Pose/A-Pose 姿态数据集以及通过 Motion Canvas 描述的行为。执行方利用最新一代 GPU 的云实例计算变形,并向客户返回已应用 Blend Shapes 以实现面部表情同步的 FBX 文件。手动编辑顶点仅保留在剧情动画中的微暂停环节,而其余全部动作均由算法生成。
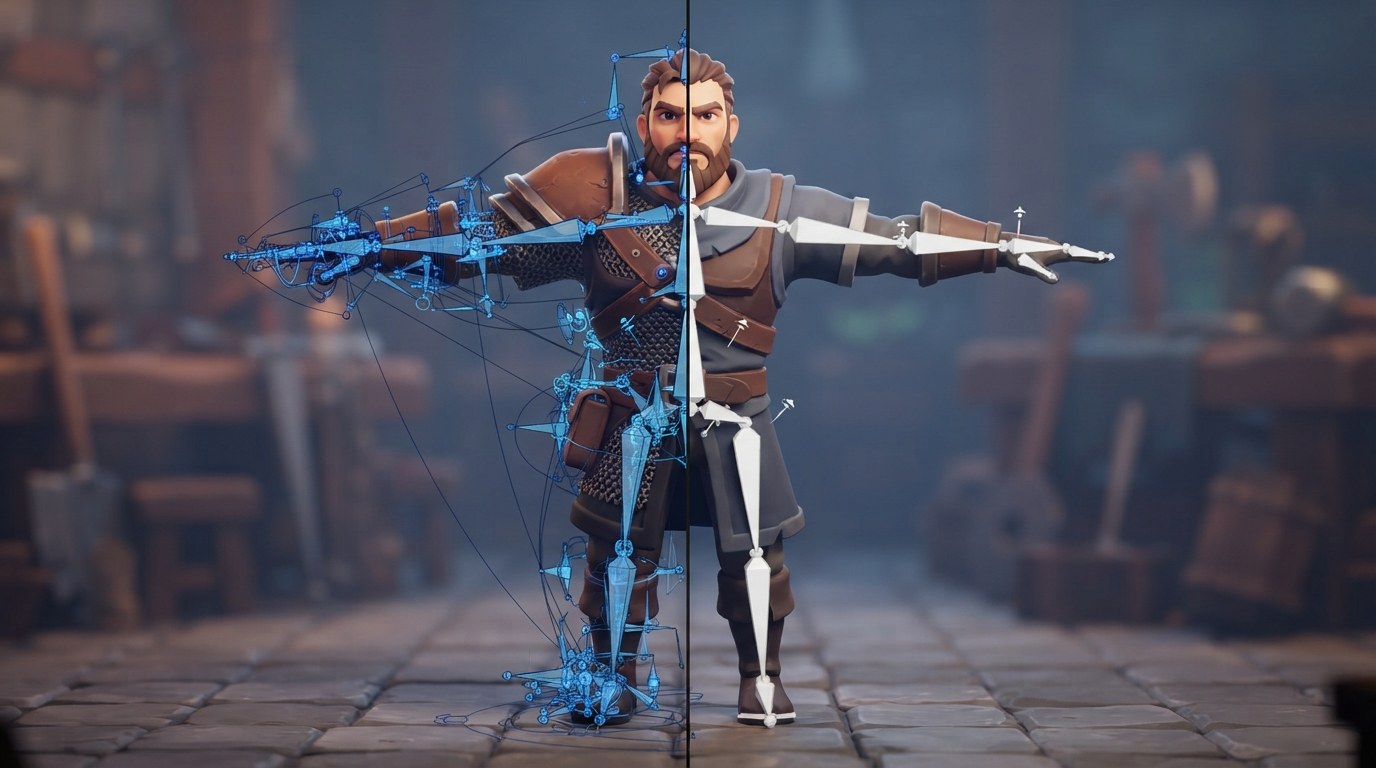
工具的演进:Auto-Rig Pro、AccuRig 和 Mixamo 在两年内发生了什么变化
在 2025–2026 年间,绑定(rigging)流水线已不再是手工活。主要的转变是从“半自动”向预测性网络迁移,这些网络不仅仅是连接骨骼,而是根据特定轮廓预测功能性骨架架构。如果以前工具在对称性和权重上互相竞争,那么现在它们在导出 FBX 之前就开始讨论运动学约束和物理正确性。
Auto-Rig Pro (Blender 4.x 版) 通过原生 Graph API 将焦点彻底转向模块化。其最大创新是 Neural Blueprint 模式。您无需手动指定肩胛骨或锁骨的控制点,只需标记髋骨和颅骨的位置。该网络会分析网格拓扑,通过 UV 集群识解剖区域,并构建考虑到预期运动范围的骨骼层级结构。2026 年的关键更新是在蒙皮过程中引入 Soft-Constraints Solver。这消除了极端姿势下肘部出现的“巧克力桥”效应,无需手动修正 Weight Painting。对于独立团队而言,支持 USDZ Schema v3 至关重要:AR 头像可一键导出至 VisionOS,并保留压缩后的 BlendShapes 池。
AccuRig (Reallusion) 2.1 版 从 Character Creator 的辅助工具演变为独立的重定向服务。过去几年的主要痛点——T-Pose 下女性模型胸部体积丢失——通过 Volumetric Preservation Maps 得以解决。算法扫描源网格,创建一个不可见的密度外壳,并确保骨骼之间的距离不会压缩几何体。2026 年的重大改变是摆脱了生成权重贴图所依赖的云渲染。本地 TensorRT 引擎使得在 RTX 级别硬件上完成 Rig 生成的时间约为 14 秒。新增了智能服装检测器:系统会自动为长袍生成第二层碰撞物理层,防止行走时布料穿透大腿。
Mixamo 曾经是速度的标杆,在与 Adobe Sensei Gen-3 集成后经历了转型。它不再是一个 MoCap 库,而是一个上下文动画生成器。您上传静态 T-Pose,网络将补全缺失的关节(例如手指),即使模型中没有这些数据。但核心是 Semantic Motion Tagging。上传模型时,您可以编写提示词:“疲惫的守卫,厚重盔甲”。系统会根据角色尺寸调整步幅和质心。对于 Unity URP/HDRP 项目,这省去了数小时的 Root Motion 设置工作。然而,出现了许可证细节问题:库存开始在 GLB 元数据中用单独标志标记 AI 生成的循环,这要求在发布前检查与平台方政策的兼容性。
DCC 的内置工具也有所提升。Maya HumanIK 获得了 Biomech Predictor 插件,该插件会根据体型类型阻止不可能的关节角度。Unreal Engine Control Rig 在 5.6 版本中学会了反向变形:更改最终控制器(Controller)的形状时,您可以实时地物理变形皮肤顶点,无需重新计算整个节点图。
演进的结论很简单:现代工具评估的不仅是骨骼应该附着在哪里,还包括该骨骼如何在特定高多边形模型的肌肉体积内“呼吸”。
现代 ML 绑定的解剖:从点云到 clean topology weights
在 2026 年的流水线中,神经网络绑定已不再是“一键魔法”,而是将原始数据转换为优化变形模型的严格工序。源数据通常来自摄影测量或 Gaussian Splatting 的密集几何体,并通过新一代 MV-HMR(多视角人体网格恢复)算法进行转换。此阶段的主要任务是将拥有隐含比例的混乱多边形云转化为具有正确比例的可预测网格,以便进入蒙皮阶段。
第一个关键环节是无体积损失的重拓扑。诸如 AutoQuad v4 或 TopoGen-X 等现代工具使用扩散 Transformer 在高面数扫描上构建四边主导的网格。与过去的方法不同,当前模型在生成 UV 展开时就已训练好保留关节的硬边(hard edges)。这避免了经典的“果冻效应”——即当骨骼轻微旋转时软组织相互渗透。对于独立工作室而言,由于模型针对 INT8 精度进行了优化,能够在 RTX 5070+ 级别的加速器上本地运行这一步骤成为了关键因素。
下一步是姿态提取。取代过时的手动 T 姿势指定的是 Pose Canonicalization Networks 架构。神经网络分析输入几何体,寻找解剖锚点(ACR points),并强制将角色矫正至 A 姿势(游戏引擎的中性姿势)。此时还会自动修正三角肌和髋关节周围的拓扑结构——这些是皮肤最大拉伸区域。此阶段的错误是致命的:肩部角度错误会导致运动捕捉动画中的权重塌陷。
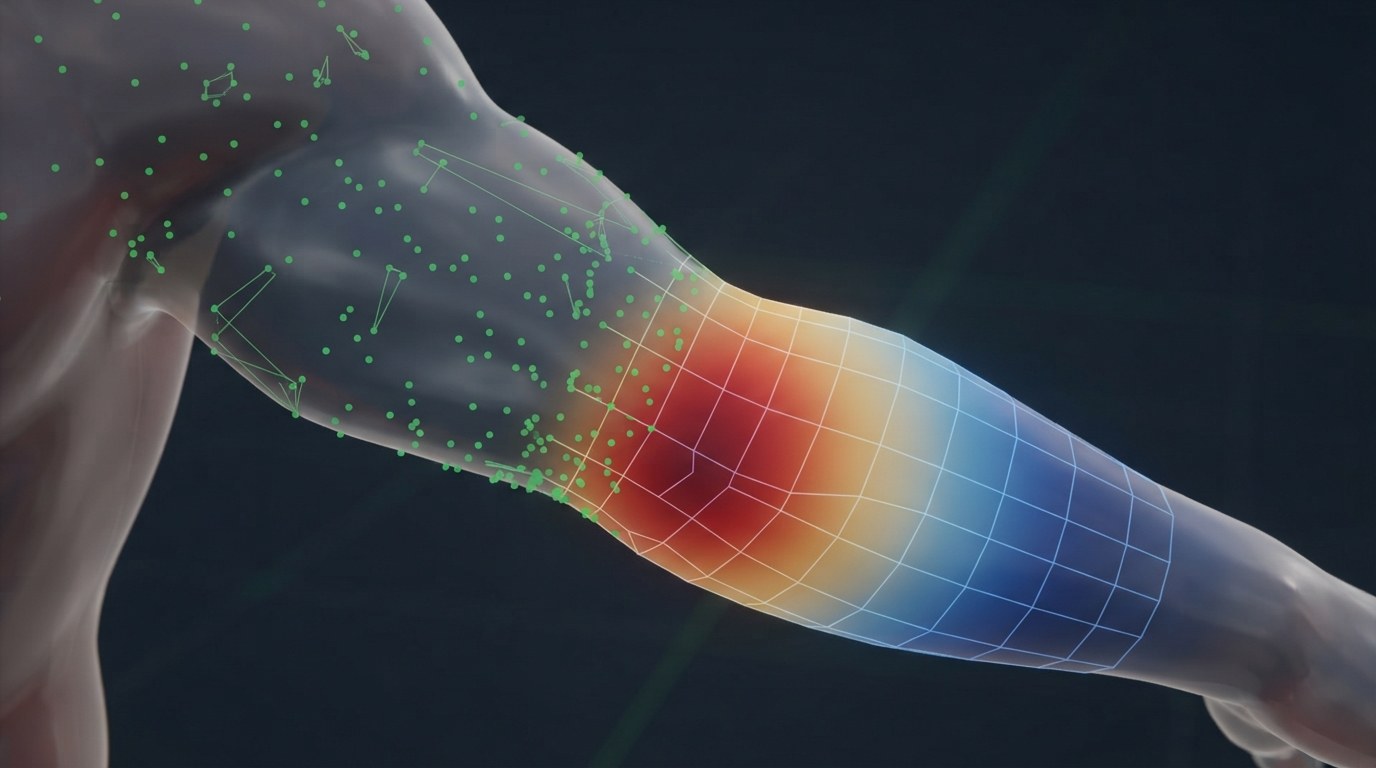
最后一阶段是计算蒙皮权重(skinning weights)。2026 年事实标准成为 Heat Diffusion + Neural Blending 的混合方法。传统的骨骼热量分配提供了基础的骨骼影响分布,但在肘部弯曲处留下伪影。网络的生成层绘制权重,以模拟皮下脂肪和筋膜的行为。谷歌 Play 和 App Store 商店目前最重要的要求是 FPS 稳定性,因此最终设置必须满足 GPU Skinning Costs 的限制:
- 移动端旗舰(iPhone 17 Pro / Android Flagship): 每个角色不超过 0.3–0.4 毫秒;
- PC/Console Indie: 严格控制每个顶点影响骨骼数量(通常每顶点最多 4 根),低于 0.01 阈值的弱权重由 CleanWeights AI 脚本自动裁剪。
特别注意 DCC 软件的兼容性。导出的 FBX 通过 USDZ Validator 2026 进行验证。如果网络检测到非流形几何体(non-manifold geometry)或变形区域内的翻转法线,则流程返回到重拓扑阶段。对于程序化角色,采用 Layered Rigging:基础脊柱只生成一次,而四肢(触手、尾巴、赛博义体)作为带有各自预计算 blend shapes 的独立图节点添加进来,用于压缩体积。
该流水线的结果是一个干净的 rig,准备接收 Motion Matching 数据或文本提示创建的动画。没有重复顶点、关节处理想的四边形以及物理上可信的权重分布,使得即使在中端设备上也能实时渲染复杂表情,这对于当前硬件周期的移动游戏市场至关重要。
新一代面部动画:局部扩散模型对抗云端 API
到 2026 年,面部表情已不再是“昂贵的附加功能”,而是叙事类游戏保持玩家注意力的基本要求。玩家已经习惯了 Unreal Engine 5.4–5.5 的光影写实以及基于音频生成的情感深度。开发者必须在两种范式之间做出选择:在设备上(On-Device)直接运行重型模型(如 Audio2Expression 或 Emotion ControlNet),以实现隐私和零延迟;或者使用按令牌和渲染秒计费的流式云端 API。
本地方案:Diffusion On-Device 与通过 LCM 优化
由于 Latent Consistency Models (LCM) 和推测解码技术被直接集成到引擎运行时,在游戏循环中运行神经网络已成为可能。在 Unity Sentis 2.3 和新的 NVIDIA ACE 插件中,本地面部绑定模型作为异步计算图工作。主要管线如下:麦克风捕获音频缓冲区,内置 DSP 滤波器去除噪声,然后输入 Transformer 编码头。它一次性生成 Blendshape 权重曲线段,而不是逐帧生成。
最大优势是对数据的完全控制。对于独立工作室来说,这至关重要,因为 Apple App Store Transparency 和 GDPR 的要求:面部生物识别数据绝不能离开设备。然而,其代价是激进的内存管理。为了避免在对话出现时卡顿,团队采用了 “Warm-up Pools” 技术:在关卡加载期间,GPU 使用空模型运行预热张量核心,使得第一次推理调用能在可预测的 18–22 毫秒内完成。这里的典型错误是尝试每帧都跑全脸网格。2026 年的正确做法是每 3–4 帧运行一次,并随后通过 Animation Rigging 的样条进行插值。
云端 API:Streaming Morph Targets 与网络妥协
像 Replica Studios Live 或 Epic Online Services 等专用终端提供的云服务,可以在不给用户显卡增加负担的情况下提供工作室级别的质量。服务器上的模型分析配音演员的语谱图,并通过 WebRTC DataChannels 协议返回包含 ARKit blendshapes 或自定义绑定值的 JSON。
2026 年选择云端的关键因素变成了对带有前向纠错 (Forward Error Correction) 的 UDP 流的支持。即使在移动互联网丢包的情况下,也能传输形状目标 (morph-targets) 数据包。主要问题是延迟 (RTT)。如果 RTT 超过 80 毫秒,嘴唇会跟不上语音,从而破坏沉浸感。解决方案是使用预测缓冲区:客户端提前半秒收到字幕文本,构建音素概率地图并提前打开角色的嘴巴。当真实的权重数据包从服务器到达时,系统仅对偏差进行微调。
混合塑形与重定向
现代 AAA 项目的标准是混合方案。轻量级本地模型瞬时处理一阶情绪(惊讶、愤怒)。云端作为后台进程连接,用于传递特定语言配音的细腻发音细节。最终网格通过 Post Process Material Layering 混合这些数据流生成。不过,最终一步仍交给传统的 Joint-based rig 处理:神经网络只输出形状目标,而组织物理、头发碰撞和身体动作捕捉则将画面打磨至完整的 Ready for Render 状态。

在 Unreal Engine 5.5+ 中的集成:Live Link、Control Rig 与 Post-ML 清理
在 Unreal Engine 5.5+ 的生态系统中,神经网络绑定(Rigging)和动画生成的管线已经从实验性工具阶段正式转变为开发标准。当前关键任务不仅是导入来自生成模型(例如 Motion Diffusion 或基于 Transformer 的 IK 求解器)的数据,而是要无缝地将其融入迭代过程,并且不会牺牲质量。
第一步:通过 Live Link 传输数据
现代用于面部追踪(FaceTrack AI)和惯性捕捉体的 ML 服务现在能够直接通过 Live Link 协议传输数据。相较于旧的 FBX 录制方式,使用 Live Link Subject 可以让您在 UE 编辑器中实时查看结果。对于自定义角色而言,使用带有骨骼重映射(Bone Remap)功能的 Live Link Preset 至关重要。到了 2026 年,大多数 SDK 会同时生成扩展曲线(Curves)和关节旋转。这些曲线应当直接映射到 Animation Blueprint 参数上,跳过在 Sequencer 中烘焙到纯动作轨道的步骤。这保留了原始数据的非破坏性。
第二步:通过 Control Rig 进行归一化 AI 生成的动画通常包含微抖动或因质量-惯性特性估计不精确导致的“穿模” артефакты。与其手动逐帧修正,不如采用双层级 Control Rig:
- Pre-processing Layer: 在此应用实用节点对进入 Live Link 的信号噪声进行滤波。使用具有自适应窗口的四元数(Quaternion)平滑函数,以免削弱冲击力度。
- Fix-up Layer: 在此级别运行反向运动学(IK)修复。如果 ML 模型在步幅长度或跳跃高度上出错,程序化腿部(MetaHuman)或自定义 Leg Solver 将在草稿播放期间立即将脚趾拉到碰撞表面(Floor Snap)。
第三步:重定向与校正图层
从通用网格绑定(Generic Metarig)迁移到特定骨骼时,使用支持按骨骼属性覆盖(Per-Bone Properties Override)的新版 Retarget Manager。然而,这里的核心工具是 Animation Layers。AI 数据放置在基础层(Base Pose)之上。随后叠加人工编写的校正层(Additive/Override layers),写在机器生成的基础之上。UE 5.5 中的 Stacked Blend Inertial Node 修饰符允许在极端加速时刻(算法最容易出现权重错误的时刻)平滑引入手动修正。
第四步:Sequencer 中的 Post-ML Cleanup
当草稿获批后,它会被发送到 Level Sequence。当前的最佳实践拒绝了完全清理动捕数据的做法。Curve Editor 现在内置了 ML Denoiser,它分析轨道的频谱并删除高于人类生物力学感知阈值的高频噪音,同时保留低频演员意图。对于面部动画,在 AnimBP 中必须应用 Jaw Wiggle Correction 节点,因为扩散模型倾向于在元音上夸张地张开嘴巴。
面向实时的优化
导出游戏前的最后阶段是 Baking to Control Rig。您将沉重的程序化计算和修正图谱烘焙为静态关键帧,但保留 Controls 层级结构。这使得关卡设计师能够在繁重的神经生成阶段完成之后,精细调整情感振幅或武器挥动速度,从而在制作速度和手工动画质量之间实现理想平衡。
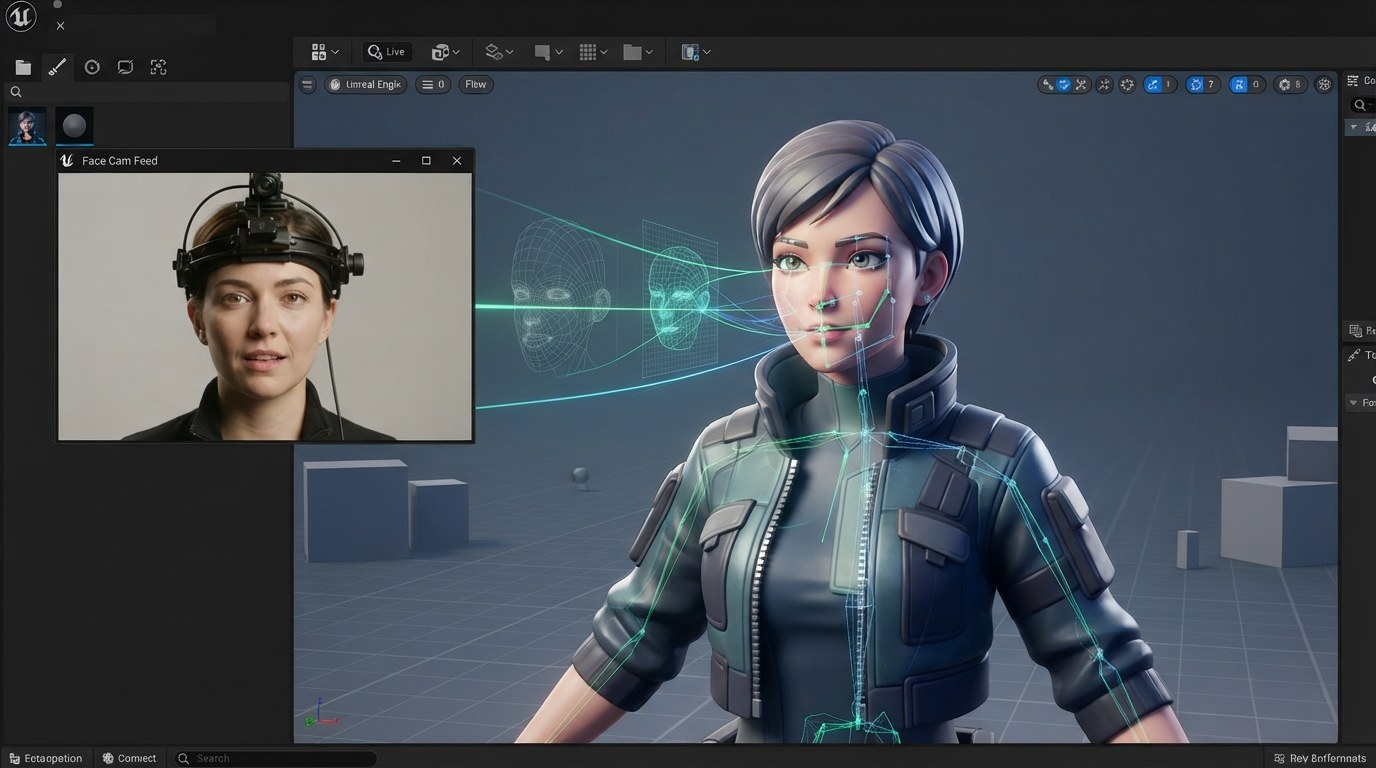
Unity 6 与 Sentis:将面部捕捉和程序化动画逻辑迁移到运行时
Unity 向统一渲染栈(URP/HDRP)架构的 Unity 6 的过渡,最终确立了神经网络作为动画管线的标准工具。Sentis Runtime AI 在其中发挥着关键作用,它允许在播放器内部直接执行优化后的 ONNX 模型推理,而无需在 CPU/GPU 之间进行 IPC 和数据序列化的开销。对于绑定来说,这意味着抛弃“烘焙”所有动作变体,转而采用动态姿态合成。
该解决方案的架构围绕两个组件展开:用于操控骨骼层级结构的 Skeleton Graph API,以及面向 Compute 的变形图。引擎不再每帧都对数百个骨骼影响进行繁重的蒙皮计算,而是使用轻量级的偏移修正模型(Delta Model)。它接受当前关节角度和 IK 求解器输出的数据,并返回顶点缓冲区的增量向量或四元数的修正值。对于指令预算受限于顶点着色器的移动平台而言,这一点至关重要。
对于面部动画,2026 年的实践规定了混合式方法。繁重的情感生成模型在编辑器中离线工作,创建基础 BlendShape 库。而在运行时,则通过 Sentis 启动一个大小仅为 5–10 MB 的紧凑回归网络。其任务是根据特定摄像机角度和场景光照混合这些形状。模型学习如何补偿 Mocap 剪辑未覆盖的极端头部旋转导致的网格失真。集成通过自定义 Animation Job 实现,在 DOTS 后端 Job System 中执行,从而保证线程安全并避免 Main Thread Time 抖动。
现代应用商店的要求对能耗施加了限制。使用 GPU 版本的 Sentis 需要谨慎处理资源屏障。推荐模式是:在角色实际显示前两帧异步执行 GPGPU 神经网络核心。数据写入中间 RWStructuredBuffer,随后被 Character Rendering 的最终 Pass 无缝接管。为了防止低内存设备出现微卡顿,采用带 LZ4 压缩的 Streaming Assets Bundle,模型的解压由运行时本机内存管理器委托处理。
Unity 6 的 Unified Path 特性允许开发者将此类计算直接嵌入材质 SubTarget 图中。开发者越来越多地放弃从 CPU 传递完整的 Morph Targets。相反,Vertex Stage 着色器会访问加载到 Texture3D 或 ByteAddressBuffer 中的张量权重。这为程序化皮肤起皱(wrinkle generation)打开了大门,其中皱纹幅度由神经网络根据 UV 条带的局部拉伸计算得出,而非基于全局的 BlendShape 值。
针对不同芯片架构的校准仍然是一个重要方面。在 Mixamo 数据集或内部 Rokoko 记录上训练的模型,需要应用 Post-training Quantization (PTQ) 将其降至 Int8/FP16。Unity 提供的 Profiler Modules 可用于分析 ANN-inference 的执行时间,独立于物理和渲染。2026 年集成的典型错误是尝试在同一个移动 SoC 的 NEON 核心上同时运行全身物理求解器和生成网络。正确的做法是利用 Sentis 的硬件加速提供者,将部分计算下放到智能手机的 DSP/NPU 上,从而让 CPU 空闲出来处理游戏玩法逻辑。
因此,Sentis 不再是实验性的附加组件。它成为原始运动捕捉数据与最终高多边形模型之间的抽象层,在传统样条轨迹跟踪因生物力学或肌肉张力无法预测织物行为的情况下,确保插值的平滑性。
Godot 4.4+ 与开源解决方案:VRM 令牌、Llama.cpp rigging bots
在独立游戏领域,Godot 凭借其 4.4+ 分支已成为角色快速原型制作的核心。该版本中,Skeleton3D 原生支持了 Heat-Map Weighting,并通过 RetargetModifier 提供了改进的重定向功能,能够在不出现“漂浮”手腕的情况下补偿比例。对于移动游戏而言,这至关重要:蒙皮预算被限制在一个顶点着色器循环内,以实现 Quest 4 和 2025–2026 年主流 Android 芯片上的目标 60 FPS。此管线围绕 open-source bot 的自动绑定构建,其中本地推理已成为事实标准。
核心工具是 Llama.cpp rigging bots。开发者集成经过微调的 Qwen 2.5 或 Mistral-Nemo(参数量可达 7B)模型,以根据网格点云预测骨骼层级结构。Bot 接受最高 15 MB 的 .glb 文件,分析拓扑密度,并输出包含基础 T/A/Pose 的 Bone Map 模板。整个过程在 Mac M3 Ultra 或 PC RTX 50-class 上耗时 8 到 20 秒。关键优势在于无需支付 API 云费用;模型在本地运行,这使得处理受 NDA 保护的项目成为可能。生成后,脚本会自动应用 Godot 自带的 Smart Weights,剔除低于 0.01 的权重以减少 draw call 漏失。
面向头像的资源导出依赖于 **VRM 1.0** 标准的演进,该标准现在能被 GLTFDocument 节点正确读取,而无需任何技巧。然而,移动端发布的特殊性要求转向 VRM 令牌概念。应用程序不再传输庞大的 Blend Shapes 形变,而是传递二进制表情令牌(viseme 权重系数),这些令牌将由用户设备上最简单的 Compute Shader 进行重建。这将打包体积缩减了 40%:客户端仅加载中性基准网格和动画关键词字典,而不是完整的个性化网格集合。
对于行走和手部交互的程序化动画,使用了 AnimationMixer 与 IK 节点以及轻量级 Motion Matching 图的组合。由于完整的 MM 对 OpenGL ES 3.0 过于沉重,Godot 采用了混合方法。神经网络离线生成 Root Motion 的草稿,作为 TransformPath 曲线。设备上运行的 State Machine 将这些剪辑与实时 Inverse Kinematics 校正混合。输入参数来自 Contextual Actions Predictor——一款约 4 MB 的 ONNX 模型,它能在当前动画完成前 120 毫秒预测玩家意图(挥动、躲避)。
常见的管线错误包括在 Blender 与 Godot 之间切换时忽略 Scale Compensation,这会导致非标准人形角色的四肢长度出错。解决方案是在导出前严格冻结 Apply Scale,并使用 Remesh Modifier Quad Only 来统一网格密度以适配 Skinning Aggregator。第二个问题是 Adreno 等弱芯片上的 Uniform Buffer Object 溢出。每网格活跃骨骼数量必须严格控制在 64 个单位以内。所有多余内容应转移到 Mesh Instances 中,或通过 Texture-based Skinning 方法将骨骼权重烘焙到纹理图集中,该方法在 4.4.1 及以上版本的 Forward+ 和 Mobile 渲染器中可用。
优化工作通过 GPUPerformanceMonitor 完成 профилированием。目标是确保场景加载时骨骼变形不超过 0.4 ms。若指标超标,则会将权重 Quantization 级别降至 half-float,并在 Import Dock 中执行激进的 Bake Lightweight Vertex Cache。这一技术栈使单人开发者能够发布可定制角色,其品质紧逼过去几年的 AAA 解决方案,同时在大众设备上保持目标帧率。
面向移动商店的优化:权重限制、量化和骨骼批处理
在 2026 年,各大应用商店对渲染性能仍保持严格限制。App Store (iOS 19+) 和 Google Play (Android 15+, API 34+) 在帧内 GPU 蒙皮时间超出限制时会使用激进的降频(throttling)配置文件。对于采用神经网络绑定(rigging)的项目而言,这意味着必须从“高质量”数据转向严格规范的管线。heavy setups 的核心问题是每个顶点受影响的权重数量以及动画关键帧的密度。
顶点权重的硬性限制
移动平台的行业标准依旧不变:每个顶点最多 4 根骨骼(4 weights)。神经网络往往会生成平滑的变形,将影响分散到 8–12 根骨骼上。在 Unity 2026 LTS 或 Unreal Engine 5.5+ 编辑器中,必须在导出 FBX/USDZ 之前强制执行 Weight Limiting SOP。算法不能简单地剔除弱影响,而应对剩余的四个最大值进行重新归一化。这可以防止几何体崩塌伪像,在 Apple Silicon A19 Pro 和 Snapdragon Elite X2 等设备上尤为重要,因为其驱动程序会严格丢弃违反规范的顶点包。
动画曲线量化(Quantization)
通过 Motion Diffusion 生成的轨道包含密集的四元数(quaternion)数据。加载此类资产会在几秒内耗尽 VRAM 预算。现代做法要求在烘焙前进行逐通道量化:
- 位置(Translation):压缩至 half-float (FP16),允许误差 0.1 cm。
- 旋转(Rotation):使用压缩格式 Quaternion Compression(例如 Dropbox Normals 格式),将数据打包成字节而非 float32。
- 缩放(Scale):如果恒定则完全移除轨道,或严格限制为仅支持线性插值,不使用三次样条。
在 Godot 4.4 中,Animation Retargeting & Compress 插件非常实用,它可自动分析曲线熵并删除冗余关键帧,仅保留改变导数方向的关键帧。
骨骼网格批处理与实例化(Instancing)
神经网络能够生成变体丰富的人群(crowd)动画。然而,每个单独的 Skinned Mesh Renderer 都会破坏批处理(Batching)。为了在中端芯片上保持 60 FPS 以上的帧率,采用了基于纹理的蒙皮技术(Texture-based Skinning / Bone Textures)。该方法不是通过 Uniform Buffer Object (UBO) 将骨骼矩阵数组从 CPU 传输过去,而是将矩阵写入高分辨率 RGFloat 纹理。着色器根据顶点 ID 读取这些数据。这使得数百个角色可以通过 GPU Instancing 合并到一个 Draw Call 中。UE5 中关键工具是 Niagara + Control Rig,甚至可以实例化唯一的 RBF 驱动状态,通过 Structured Buffers 传递变形参数。
运行时约束(Runtime Constraints)和骨骼 LOD
对于面部表情,采用 Bone LOD 技术。当距离超过 10 米时,下颚、眼睛及细小表情骨骼会被 Runtime Constraint 脚本禁用。它们的变换被冻结,变形由父级 blendshape 捕获。这对于 Quest 4 和 Vision Pro 至关重要,因为其计算单元正忙于凹陷渲染(foveation)。同时,导入设置中的 Optimize Game Objects 也已成为必选项:层级结构必须被扁平化(Flattened),去除神经模型喜欢添加用于空间结构化的中间零节点。
最终检查阶段是 Asset Bundle Validation 在构建控制台中的输出。如果角色原始动画轨道总大小超过 20 MB,则认为生成算法失衡,并需要使用 Sparcity Loss 正则项进行再训练。
质量门槛与陷阱:AI 产生垃圾数据时以及如何构建 QA 检查清单
在 2026 年,通过神经网络进行自动绑定(Rigging)已不再是实验,但也并非魔法。诸如 AutoRig Pro ML、Blender 4.5 和 Unreal Engine 5.6 原生管线之类的工具可以在几秒钟内提供优秀的基础骨架,然而“未加工”导出的文件仍会在集成阶段破坏游戏。主要风险在于对流水线的错误自信。如果您在没有严格过滤的情况下就接受结果,那么随着每个新资产批次的加入,技术债务将呈指数级累积。
自动蒙皮和层级结构的关键错误
- 双重变换(Double Transform)。 从视频参考生成 Control Rig(Motion-to-Rig)时最常见的问题。网络可能将几何体绑定到骨骼 并且 保留了已经被骨骼姿势所涵盖的活跃校正 Blendshapes。结果就是网格抖动或拉伸两倍。检查方法:在 T-Pose 下冻结骨骼变形;如果网格自行变形——寻找多余的 Shape 或 Morpher 之后的 Skin 修改器。
- “幻影”父级(Phantom Parenting)。 AI 经常创建中间空节点(Null Nodes)来补偿轴向,却忘记将 Inherit Scale/Rotation 标志设为 False。在跑步动画中,腿部会随躯干一起缩放。检查清单要求在蒙皮前使用比例检查工具(World-Space Unit Check)遍历所有关节。
- 接缝处权重塌陷。 生成式网络喜欢在需要平滑的地方绘制硬边(Hard Edges)。肘部和肩部的弯曲多边形获得零权重。在 Godot 4.4 中,这会导致在使用 JiggleBone 物理修正器时网格断开。
- 受权重影响的法线反转。 在从库中激进地迁移权重(Weight Transfer AI)时,手套或盔甲的内部空洞可能仅在特定手腕旋转角度下发生翻转。
手动精细打磨的方法
如果遵循严格的协议,技术美术从草稿过渡到成品大约需要 30–40 分钟每角色。首先执行权重拓扑清理。使用 Quad Weight Painting 之类的工具:强制将变形区域转换为四边形分布权重(100-0, 75-25, 50-50),剪除嘈杂模型生成的随机值 33.3% 或 8%。
第二阶段是稳定质心。神经网络 Motion Capture 提供的是活泼但杂乱的髋部(Hips)。请仅对根骨骼的 Y 轴平移应用滑动平均滤波器(Windowed Average Filter),保持 X 和 Z 轴尖锐以响应 геймпад。这将消除 Apple Vision Pro SDK 2 或 Rokoko Video 的原始数据中常见的“醉汉走路”效果。
实时表情(Blendshapes)的特殊性
如果面部动画由 Audio-to-Face 模型生成,请控制活动目标的数量。现代 GPU 可以容纳数百个形状,但运行时 LOD 驱动程序会削减它们。请将微表情(低于 5% 的权重)烘焙到 Normal Offset 压缩纹理贴图中,而不是顶点动画。对于 Meta Quest 4 和 PS VR2 Remix,严格限制每帧最多 32 个活跃变形。
接收检查清单(Gatekeeper List) 在将资产提交至 Perforce/Git 之前,请确保:
- 骨骼比例在世界坐标中严格为 1.0 / 1.0 / 1.0。
- 层级中的任何骨骼都没有负比例(Negative Scale)——这会破坏 Forward+ 渲染中的法线计算。
- Root Motion 曲线已从 Animation Asset 中单独提取,以支持 UE5 中的 Network Replication。
- Skinning Quality Score(Unity 6 Muscle Group Solver 内置指标)高于 90 分,且无需在超过 15 个关节上进行手动修正。
AI 加速了生产,但它不理解游戏上下文:披风在狭窄门口的穿插,或攀爬时 IK 抓脚的必要性。最终发言权始终属于了解这些错误在 FPS 毫秒计价中的代价的 TA。
工作室经济:计算用 SaaS 订阅工具替换全职绑定师的 ROI
在 2026 年,“雇佣专家还是购买软件”这一关于角色动画任务的问题已经转变为资本支出(CapEx)与运营支出(OpEx)之间的选择。神经网络绑定市场提供了成熟的解决方案,能够在几秒钟内生成基础骨骼(FK/IK)、蒙皮权重(skinning)和基础姿势。然而,用云端订阅来替换关键员工需要对投资回报率(ROI)进行冷静的计算。忽视集成过程中的隐性成本往往会导致预算超支。
内部团队(In-house)成本模型。2026 年,东欧高级角色技术美术/绑定师(Senior Character TD/Rigger)的中位税前月薪约为 $3500–$4500。考虑到社保缴费和间接费用,工作室每月为一名专家花费约 $5500。全职员工不仅负责创建绑定,还要维护管线:在更换引擎版本时适配资产(Unity 6.x LTS 搭配 Entity Component System v2.0,Unreal Engine 5.5+),编写自动化实用工具以及修复 FBX/USD 导出错误。这些任务目前只能由 AI 部分覆盖。
订阅模型(SaaS AI Rigging)。现代动画和绑定生成平台采用按令牌消耗或固定座位费计费模式。拥有 API 访问权限以批量处理资产的高级服务平均单价在每用户每月 $150 至 $400 之间。此外,生成一个复杂网格的成本取决于多边形数量。对于一个中型独立工作室项目(约 30 个唯一角色加上服装变体),月账单可能达到 $800–$1200,其中包括因权重伪影导致的重复迭代开销。
盈亏平衡点计算。直接比较显示 AI 更具优势:$1200 对比 $5500。但 ROI 公式必须纳入部署时间。将第三方 API 集成到编辑器工具(Editor Tooling)中,需要一名中级程序员(约 $3000/月)耗时两周——这是一笔一次性成本约 $1500。接下来是流水线速度的考量。如果全职绑定师制作一个复杂模型需要 2 天,而 AI 生成草稿只需 3 分钟,节省的时间是巨大的。然而,最终的关节点方向(joint orientation)微调和自动蒙皮后双旋转矫正仍然需要初级人员($1200/月)的人工劳动。
隐性风险和数据税。2026 年最大的陷阱是对云端的依赖。在高峰负载下,服务延迟增加,阻塞艺术部门的工作。此外,通过 AI 导出的数据可能包含针对移动平台(Quest 4, Vision Pro 2)并不友好的权重拓扑。手动优化这样的绑定可能会消耗掉 40% 的节省时间。法律层面至关重要:请确保 SaaS 许可证向您转让输出网格(output mesh rights)的完整版权且无需支付版税(royalty-free),否则 Google Play 或 App Store 等商店在审核资产来源时可能会拒绝打包。
最佳混合策略。最佳 ROI 是放弃招聘第二位 Senior 绑定师,改用 Junior TA + SaaS 订阅组合。神经网络在几分钟内提供基础,初级技术美术清理网格并设置布料物理(Chaos Cloth / NVIDIA Flex),而 Senior 仅参与创建复杂的面部设置(Blendshapes)和程序化控制器。这种方案将人力成本降低至少 35%,同时保留质量控制。在预生产阶段,当需要快速原型化数十种移动性包(mobility packs)以验证元宇宙假设时,这种节省达到了最大值。