


2026–2027年移动硬件格局:目标设备规范与图形API
在2026年使用Unity 6开发高性能3D游戏,需要深入了解近年来移动硬件技术栈的变化。陈旧的图形API OpenGL ES 3.x时代已彻底终结:Google Play和Apple App Store实际上已将Vulkan 1.3和Metal 3确立为现代图形的绝对标准。在Unity 6中尝试支持过时的图形管线,将导致项目无法使用关键的架构特性——从直接管理缓冲区同步到GPU端硬件加速的命令绘制。
为了在2026–2027年设计目标图形画质预设和伸缩系统,我们将硬件划分为三个关键类别:
- Low-End(最低预设 / 大众市场 30 FPS):基于Arm Mali-G610/G710、骁龙6系列及入门级Exynos芯片组的设备。配备4–6 GB LPDDR4X/LPDDR5内存。图形API为Vulkan 1.3,但不提供无绑定资源(bindless)扩展支持。主要瓶颈:内存总线带宽狭窄(最高25–30 GB/s),且在使用重度PBR材质/着色器时极易发生缓存未命中(cache miss)。
- Mid-Tier(目标预设 60 FPS):基于骁龙7系列(包括Gen 4/5)、天玑8300/8400和Apple A16/A17的中高端设备。配备8–12 GB LPDDR5X内存,完整支持Vulkan 1.3(必须包含 `VK_EXT_descriptor_indexing` 和 `VK_KHR_dynamic_rendering`)。该档位设备能够稳定运行Unity 6的混合管线,并充分利用GPU Resident Drawer及复杂的剔除(culling)启发式算法。
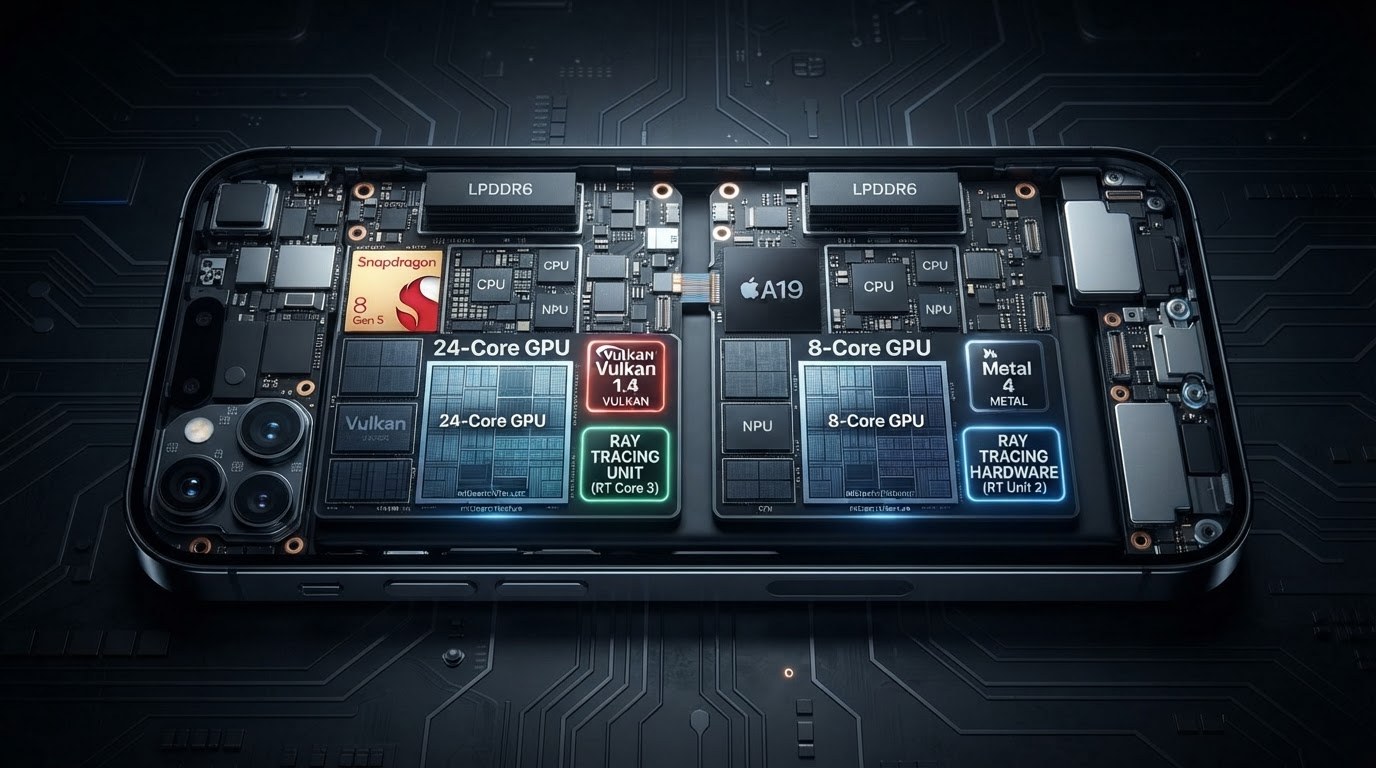
- High-End / Flagship(高帧率,90–120 FPS,硬件光线追踪):基于Apple A19 Pro / M5、Qualcomm 骁龙8 Elite / Gen 5及联发科天玑9500+的旗舰解决方案。配备12–16 GB超高速LPDDR5X/LPDDR6内存。支持硬件级网格着色(Mesh Shading)、实时光线追踪以及用于神经网络超分辨率缩放的内置NPU模块(MetalFX Spatial/Temporal、FidelityFX Super Resolution 3.1 Mobile)。
针对移动端GPU进行优化的核心考量,依然是Arm Immortalis、Qualcomm Adreno和Apple GPU等芯片所采用的TBDR(Tile-Based Deferred Rendering,基于图块的延迟渲染)架构特性。与桌面端即时模式(Immediate Mode)架构不同,TBDR芯片将屏幕划分为微小的图块(通常为16x16或32x32像素),并在高速片上内存(On-Chip SRAM / Tile Memory)中完成几何体和片段的处理。
2026年针对TBDR优化的首要法则,就是防止内存带宽瓶颈(bandwidth throttling)。将中间数据从图块内存频繁传输到LPDDR主存并返回,会导致设备严重发热。TBDR的主要架构瓶颈在于图块渲染通道(Tile Pass)的打断:
- 未优化的渲染通道(Render Passes):使用未批处理的后处理特效,或频繁切换帧缓冲区(Render Targets)且未显式指定 `StoreAction.DontCare` 或 `LoadAction.Clear`,会迫使GPU将图块内容刷新到全局RAM中,从而严重毁灭性能。
- 过度的透明度混合(Alpha Blending)层数:绘制多个半透明图层(粒子、密集植被、UI)会引起图块内片段重绘(Overdraw)的巨大负载,导致帧率骤降。
- 低效的深度预Pass(Depth Pre-pass):在TBDR架构上,硬件级HSR(Hidden Surface Removal,隐藏面消除,例如Apple GPU中的HSR或Adreno中的Early-Z)已在图块层级自动运行。非必要地使用手动Depth Pre-pass会向管线顶点阶段引入冗余负载,并增加几何体数据传输量。
2026年的另一个重大威胁仍然是过热降频(Thermal Throttling)。现代2纳米和3纳米制程工艺使移动SoC能够展现出惊人的峰值性能,但如果没有严格控制TDP(热设计功耗),设备在游戏的前3–5分钟内就会过热。降频时GPU频率的跌幅可达40–50%。Unity 6现代优化管线的目标,绝不仅仅是在冷机状态下的基准测试中展示稳定的60 FPS,而是在长达45分钟的游戏会话中保持平稳的帧节奏(Frame Pacing)和极低的功耗。
Unity 6在URP中转向全新的Render Graph API并引入GPU Resident Drawer,正是为了契合2026–2027年的硬件特性而设计的。这些改进大幅降低了CPU在准备绘制调用(Draw Calls)时的开销,使资源管理控制权能够直接交由GPU处理,从而在最小化LPDDR内存总线调用的同时,充分利用处理器的图块内存。
面向移动端设备的 Unity 6 架构:URP 与 Render Graph 新特性解析
Unity 6 架构中通用渲染管线(URP)的演进,标志着从命令式渲染模型向完全声明式的图(Graph)管线的彻底转变。在当下的移动开发实践中,优化的核心不再仅仅是降低模型面数,而是有效地管理内存带宽(Memory Bandwidth)并防止移动 SoC 发生散热降频(Thermal Throttling)。采用 TBDR(基于瓦片的延迟渲染)架构的移动 GPU(如 ARM Mali、Qualcomm Adreno 和 Apple Silicon 方案)对图块本地内存(SRAM)与系统内存(DRAM)之间多余的读写操作极其敏感。Unity 6 针对这些限制给出的核心架构解决方案,就是经过重构并设为必选的 Render Graph 机制。
在引擎的前几代版本中,工程师需要通过调用 `RenderTexture.GetTemporary` 手动控制临时纹理,这经常导致显存(VRAM)碎片化、产生隐蔽的 `CopyTexture` 调用以及移动 GPU 帧缓冲区上多余的 `Load/Store` 操作。在 Unity 6 中,Render Graph API 会在将命令提交给底层图形 API(Vulkan 1.3 或 Metal 3)之前,自动构建由所有渲染 Pass 组成的有向无环图(DAG)。这使得引擎能够对整帧进行端到端的静态与动态优化。
Unity 6 中直接影响移动端 3D 项目性能的 URP 核心架构创新包括:
- 瞬态资源(Transient Resources)的自动管理与内存别名(Memory Aliasing): 帧缓冲区(深度缓冲区、阴影贴图、MSAA 附件、中间 HDR 纹理)严格仅在特定图节点执行期间分配。内存别名(Memory Aliasing)机制在物理上将时间线互不重叠的缓冲区重叠映射到 GPU 内存的同一地址范围内,从而显著降低游戏的整体显存占用(VRAM footprint)。
- 自动 Pass 合并(Pass Merging)与原生 Subpass: Render Graph 会分析相邻的 Pass,并自动将其转换为原生的 Vulkan Subpass 或 Metal Render Command Encoder。数据(例如法线和深度)可以直接在芯片高速 Tile Memory(SRAM)内部在不同 Pass 之间传递,无需刷新写回 DRAM,从而将渲染时的芯片功耗降低高达 35–40%。
- C# API 层面的零分配(Zero-Allocation): 在 Unity 6 中,Render Graph 的构建和校验阶段在托管堆(Managed Heap)中完全没有内存分配。Pass 和调用上下文采用了基于 `NativeArray` 的高效数据结构以及专门的底层命令缓冲区,将渲染期间垃圾回收(GC)开销降至零。
- 计算着色器(Compute Shaders)的直接集成: 现已能够将 GPU 计算(GPU Culling、粒子模拟、程序化生成等)无缝嵌入到整帧图逻辑中,由 Unity 自动插入所需的执行与内存屏障(Execution & Memory Barriers)。
更新后的架构中,另一个重要部分是 Frame Debugger 工具。它不仅能展示 `DrawCall` 链,还能直观呈现 Render Graph 的实际拓扑结构:RenderPass/Subpass 的物理边界、内存别名以及不必要的瓦片刷新(Tile Flush)触发点。这有助于在编辑器内性能分析(Profiling)阶段就发现架构上的错误——例如,因脚本过早读取纹理而意外引发的瓦片刷新。
Unity 6 的 URP 架构将移动端优化的重点从简单粗暴地减少 Draw Call 数量,转移到了构建合理高效的帧图设计上。对于现代移动端 3D 游戏而言,合理配置 Render Graph 是在不导致设备过热和快速耗电的前提下,实现稳定 60 或 120 FPS 的基石。
Unity 6 中的 GPU Resident Drawer:移动端 GPU 降低 Draw Call 的革命性技术
多年来,CPU 端的性能瓶颈一直是移动端 3D 游戏优化的核心痛点。在现代移动芯片组(如骁龙、天玑和苹果 A 系列)常见的瓦片延迟渲染(TBDR)架构中,GPU 能够高效利用几何数据,但 CPU 端的场景准备工作却构成了关键瓶颈。每一帧,CPU 都必须执行视锥体剔除(Frustum Culling)、对不透明和半透明对象进行排序、生成 Draw Call 列表并将变换矩阵传输至 GPU 显存。在 Unity 6 中,集成于全新通用渲染管线(URP)的 GPU Resident Drawer (GRD) 技术彻底改变了这一范式,将几何体处理和 Draw Call 准备工作完全移交给了 GPU 侧。
GPU Resident Drawer 的核心基于低级 API BatchRendererGroup (BRG) 的演进。在传统管线(包括经典的 SRP Batcher)中,即使对象在空间中的位置未发生改变,CPU 仍需遍历每个已注册的对象,以确认其可见性并更新 Uniform 缓冲区。而 GPU Resident Drawer 将变换矩阵、材质数据和实例数据转移到显存中的持久化(常驻)存储中——即所谓的 GPU Resident Data Buffer(通过 StructuredBuffer 或 SSBO 实现)。现在,变换信息仅在对象生成或实例化时一次性加载到显存中,当发生变更时,再通过计算着色器(Compute Shader)或异步写入指令进行定向更新。
GRD 最大的突破在于将 GPU 视锥体与遮挡剔除(GPU Frustum & Occlusion Culling) 阶段完全交由计算着色器(Compute Shader)处理。使用 GPU Resident Drawer 的帧渲染流程基于以下高效算法构建:
- 数据持久化: 场景将几何体、LOD 层级和材质数据以紧凑数据结构的形式直接存储在显存中,消除了每帧的主机到设备(Host-to-Device)数据传输。
- GPU 剔除: 计算着色器在几何体渲染阶段之前运行。它并发检查数千个对象的包围盒(Bounding Box)与摄像机视锥体的交集;若开启了层次化 Z 缓冲区(Hi-Z),还会剔除被遮挡的对象(Occlusion Culling)。
- 间接缓冲区构建: 计算着色器无需 CPU 传递 Draw Call 列表,而是自行在 GPU 内存中生成指令数据(Count 和 Offset),为间接绘制调用(Indirect Draw)准备参数。
- 间接绘制执行: GPU 通过 Vulkan 1.3/1.4 中的
vkCmdDrawIndexedIndirect或 Metal 3 中的drawIndexedPrimitives等硬件指令直接执行命令。整个帧的构建过程无需 CPU 主线程(Main Thread)或渲染线程(Render Thread)的任何干预。
在移动端图形架构(如 ARM Mali-G720/G820、高通 Adreno 750/800 系列、Apple Graphics)上,这从根本上降低了功耗与热降频(Thermal Throttling)。以往在渲染包含数万个环境元素(植被、山石、细碎道具、建筑)的复杂开放场景时,仅准备绘制调用一项,CPU 渲染线程就需要耗费 6 到 12 毫秒。而应用 GPU Resident Drawer 后,CPU 渲染线程的负载可降至零点几毫秒(通常为 ~0.2–0.5 ms),因为 CPU 只需要向 GPU 发送一条控制渲染阶段的总指令。
为了在 Unity 6 中释放 GPU Resident Drawer 的全部潜力,开发者必须遵循特定的着色器和结构化数据规范。图形材质必须支持 DOTS Instancing。在 Shader Graph 中,只需在 Target Settings 属性中勾选 Enable DOTS Instancing 复选框即可完成配置。如果使用手写 HLSL 着色器,则需要引入 UNITY_DOTS_INSTANCING_START 和 UNITY_DOTS_INSTANCED_PROP 宏,以便通过字节地址缓冲区(ByteAddressBuffer)正确重定向对矩阵的访问。
对高负载移动端场景(50,000 个静态和半动态对象)的渲染性能对比测试显示了以下数据:
- SRP Batcher(传统方式): CPU 渲染线程:8.4 ms | Draw Call 数量:~4,200 | 游戏运行 4 分钟后出现 CPU 受限的热降频。
- GPU Resident Drawer (Unity 6 URP): CPU 渲染线程:0.3 ms | 实例化 Draw Call 数量:~18(æŒ